LlamaIndex Open Source RAG Framework für Document Agents 2026: Indexing, Retrieval, agentic Workflows. Mit Ollama im DSGVO konformen NCA Stack. Beratung von Experten.
Mehr erfahren
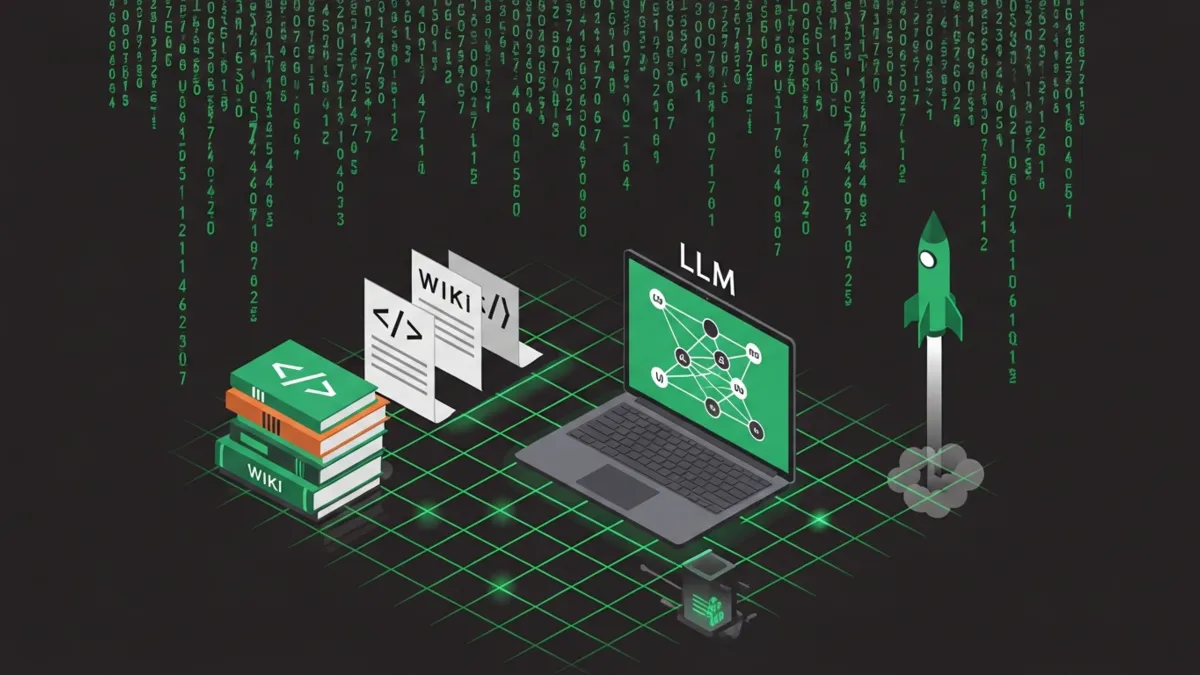
Das Karpathy LLM Wiki ist ein Muster für Wissensdatenbanken, das Andrej Karpathy am 4. April 2026 als GitHub Gist veröffentlicht hat. Ein LLM pflegt dabei eine dauerhafte Sammlung verlinkter Markdown Seiten, statt Wissen bei jeder Frage neu aus Rohdokumenten abzuleiten.
Karpathy fasst die Idee so zusammen: Obsidian ist die IDE, das LLM ist der Programmierer, das Wiki ist die Codebasis. Das Wiki wächst mit jeder Quelle und jeder Frage. Das LLM übernimmt die Fleißarbeit: zusammenfassen, verlinken, ablegen, aufräumen. Der Mensch kuratiert und denkt.
Im weiteren Sinn steht der Begriff auch für Karpathys gesamtes Lehrwerk rund um Large Language Models. Karpathy war Gründungsmitglied von OpenAI, Director of AI bei Tesla und gründete 2024 Eureka Labs. Seine GitHub Projekte, sein Blog und sein YouTube Kanal bilden zusammen ein praxisnahes Nachschlagewerk. Für Teams, die autonome KI Agenten entwickeln oder lokale Modelle mit Ollama betreiben, ist das der ideale Einstieg.
Ein Tag inhouse mit Benjamin Klein für Developer, Tester und Admins. Context Engineering, Harness, ADRs und zwei Hands on Blöcke mit KI Agenten in eurem Setup.
Karpathys Ansatz, LLMs von Grund auf zu verstehen, ist bei NCA gelebte Praxis. Wir arbeiten täglich mit Claude Code und OpenCode, pflegen Regeln für Agents in Markdown Dateien wie CLAUDE.md und betreiben einen lokalen KI Stack mit Ollama. Roland Golla ist Cypress Ambassador und seit über 20 Jahren auf Testing und Refactoring spezialisiert. So verbinden wir das Tempo von KI mit den Guardrails, die Produktionscode braucht.
Wenn du Karpathys Ideen im Team produktiv machen willst, unterstützen wir dich beim Vibe Coding Consulting, bei der Auswahl passender KI Modelle für Entwickler, beim Aufbau eines lokalen Stacks mit Ollama, bei Regeln für KI Agents in RULES.md und AGENTS.md und mit unseren Best Practices für KI-gestützte Entwicklung.
Karpathy beschreibt drei Schichten:
Drei Operationen halten das Wiki lebendig:
Der Unterschied zu klassischem RAG mit Embedding Modellen: RAG sucht bei jeder Frage neu in den Rohdaten. Das LLM Wiki kompiliert Wissen einmal und baut es dann weiter aus. Als Oberfläche schlägt Karpathy Obsidian vor, als Agent eignet sich etwa Claude Code. Wer Wissen strukturiert austauschen will, findet im Open Knowledge Format einen offenen Standard. Für klassische RAG Pipelines bleibt ein Framework wie LlamaIndex die passende Wahl.
Karpathys GitHub ist eine der wertvollsten Open Source Ressourcen für LLM Entwickler. Die bekanntesten Projekte im Überblick:
Alle Projekte folgen demselben Prinzip: kein Framework Ballast, keine Abstraktion, die das Verständnis verschleiert. Wer nanoGPT einmal selbst trainiert hat, versteht Kontextfenster, Attention und Token Limits auf einer Tiefe, die keine Doku vermittelt. Das hilft direkt, wenn du mit lokalen Modellen über Ollama arbeitest, Agent Frameworks wie CrewAI oder LangGraph einsetzt oder den Claw Code Agent nutzt.
Eines von Karpathys einflussreichsten Konzepten ist das LLM OS: die Idee, ein Large Language Model nicht als Chat Tool zu sehen, sondern als Kern eines Betriebssystems für KI Agenten. Das LLM übernimmt die Rolle der CPU. Externe Tools wie Code Interpreter, Browser, Datenbanken und APIs sind die Peripheriegeräte.
Die Konsequenz: Wer nur das Chat Interface eines LLMs nutzt, sieht nur einen Bruchteil des Potenzials. Das volle LLM OS entfaltet sich erst, wenn Agenten planen, Tools aufrufen und Ergebnisse iterativ verarbeiten. Frameworks wie CrewAI und LangGraph setzen dieses Prinzip direkt um. Das LLM Wiki passt in dasselbe Bild: Es ist das Dateisystem, in dem der Agent sein Wissen ablegt.
Bei NCA übersetzen wir das LLM OS Konzept in die Beratung: von der Architektur KI-gestützter Content Pipelines bis zur Integration lokaler Modelle in Symfony und PHP Anwendungen. Auch autonome Agenten wie OpenClaw basieren konzeptionell auf dieser Metapher.
Neben seinen GitHub Projekten hat Karpathy Lehrvideos produziert, die als Standard für das Selbststudium von LLMs gelten:
Diese Videos sind keine Theorie. Jedes baut auf lauffähigem Code auf, den du direkt anpassen kannst. Wer verstanden hat, wie GPT intern funktioniert, kann KI Modelle für Vibe Coding deutlich fundierter vergleichen. Für den Einstieg in die Debatte um AGI und KI Modelle empfehlen wir die Zero to Hero Playlist als ersten Schritt.
Karpathys Philosophie des Verstehens von Grund auf ist der Kern unseres Vibe Coding Consulting. Wer weiß, wie ein Transformer intern rechnet, schreibt bessere Prompts, wählt das richtige Modell für den Use Case und erkennt, wann ein LLM halluziniert statt zu wissen.
Diese Karpathy Prinzipien tragen wir in die Beratung:
Wer diese Prinzipien im Team verankern will, braucht mehr als ein Tutorial: Onboarding Sessions, echte Guardrails und einen Partner, der Vibe Coding auf Enterprise Level begleitet. Genau dort setzen wir an, von der Modellauswahl über Vibe Coding Best Practices bis zum lokalen KI Stack mit Ollama.
Obsidian is the IDE; the LLM is the programmer; the wiki is the codebase.
LlamaIndex Open Source RAG Framework für Document Agents 2026: Indexing, Retrieval, agentic Workflows. Mit Ollama im DSGVO konformen NCA Stack. Beratung von Experten.
Mehr erfahren
Vibe Coding Consulting von NCA: Code Review, Deployment, DSGVO und Mentoring. Erstes belastbares Ergebnis meist in 15 bis 30 Arbeitstagen je nach Projekt.
Mehr erfahrenDas LLM Wiki Muster ist uns vertraut. Wir pflegen Regeln und Kontext für Coding Agents in Markdown Dateien und lassen den Agent sie mitpflegen. Der Gewinn: Wissen bleibt im Repository, statt in Chatverläufen zu verschwinden.
In der Beratung sehen wir drei typische Einsatzfelder:
Wichtig bleibt die Kontrolle. Ein Wiki, das ein LLM schreibt, braucht Review und regelmäßige Lint Läufe, sonst wachsen Fehler mit. Wer sensible Daten verarbeitet, betreibt das Modell lokal, etwa mit Ollama, und kennt die Regeln aus unserem Beitrag zu lokaler KI für Compliance. Für Notizen ohne Cloud eignen sich auch Logseq oder eine Obsidian Ablage mit Astro als Frontend.
Roland Golla ist Entwickler aus Leidenschaft – seit über 20 Jahren. Er hat hunderte Projekte begleitet, von Legacy-Refactoring bis KI-Integration. Bei Vibe Coding verbindet er das Beste aus beiden Welten: Die Geschwindigkeit von KI-generiertem Code mit der Qualität professioneller Softwareentwicklung. Kein Bullshit, keine Agentur-Floskeln – direkte Hilfe von jemandem, der selbst täglich im Code steckt.
Die wichtigsten Fragen zum LLM Wiki Muster sowie zu Andrej Karpathys Projekten, Kursen und Konzepten für Entwickler im Überblick.
Das Karpathy LLM Wiki ist ein Muster für Wissensdatenbanken, das Andrej Karpathy am 4. April 2026 als GitHub Gist veröffentlicht hat. Ein LLM pflegt eine dauerhafte Sammlung verlinkter Markdown Seiten aus Rohquellen. Fragen beantwortet es aus diesem Wiki, neue Erkenntnisse fließen zurück. Im weiteren Sinn steht der Begriff auch für Karpathys gesamtes Lehrwerk zu LLMs.
Du brauchst drei Dinge: einen Ordner mit Rohquellen, einen Ordner für das Wiki und eine Schema Datei wie CLAUDE.md mit Regeln für Struktur und Abläufe. Ein Coding Agent wie Claude Code liest neue Quellen ein, schreibt Wiki Seiten und verlinkt sie. Als Oberfläche eignet sich Obsidian. Regelmäßige Lint Läufe finden Widersprüche und verwaiste Seiten.
RAG sucht bei jeder Frage neu passende Abschnitte in den Rohdaten und gibt sie dem Modell als Kontext. Das LLM Wiki kompiliert Wissen dagegen einmal in strukturierte Markdown Seiten und baut sie laufend aus. Dadurch wächst das Wissen mit jeder Quelle. RAG bleibt stark bei sehr großen, oft wechselnden Datenbeständen, das Wiki bei kuratiertem Wissen.
Andrej Karpathy ist KI Forscher und Lehrer. Er war Gründungsmitglied von OpenAI, Director of AI bei Tesla und hat an der Stanford University den Deep Learning Kurs CS231n mitgeprägt. 2024 gründete er Eureka Labs für KI-gestützte Bildung. Anfang 2025 prägte er den Begriff Vibe Coding. Seine Lehrprojekte teilt er frei auf GitHub und YouTube.
nanoGPT ist eine minimalistische Implementierung zum Training von GPT Modellen in PyTorch. Der Trainingsprozess eines Transformers passt in wenige hundert Zeilen Code. Für Entwickler, die LLMs wirklich verstehen wollen, ist das der direkteste Einstieg ohne Framework Ballast. Für den kompletten Weg bis zur Chat Oberfläche hat Karpathy später nanochat veröffentlicht.
nanochat ist Karpathys Projekt vom Oktober 2025. Es zeigt in einem schlanken Repository den kompletten Weg zu einem kleinen ChatGPT Klon: Tokenizer, Pretraining, Finetuning, Evaluation, Inferenz und eine Web Oberfläche. Es baut auf den Ideen von nanoGPT auf und ist bewusst lesbar gehalten, damit Entwickler jeden Schritt nachvollziehen und verändern können.
autoresearch ist ein Projekt vom März 2026. KI Agents führen dabei selbstständig Experimente am Training eines kleinen nanochat Modells auf einer einzelnen GPU durch. Der Mensch gibt die Richtung vor, die Agents probieren Änderungen aus und messen das Ergebnis. Das Projekt zeigt im Kleinen, wie Agents iterative Forschungsarbeit übernehmen können.
llm.c ist Karpathys Projekt, GPT Training in reinem C und CUDA umzusetzen. Damit zeigt er, wie Backpropagation, Forward Pass und Matrixmultiplikationen auf Hardware Ebene ablaufen. Es ist ein Lehrprojekt für Entwickler, die verstehen wollen, was unter der Abstraktion von PyTorch passiert, und warum Performance am Ende eine Frage der Hardware ist.
Das LLM OS ist Karpathys Metapher für KI Systeme: Das LLM ist der Kern eines Betriebssystems und steuert externe Tools wie Code Interpreter, Browser und APIs wie Peripheriegeräte. Es beschreibt, wie autonome Agenten aufgebaut sein sollten. Das LLM Wiki ergänzt das Bild um ein Dateisystem, in dem der Agent sein Wissen dauerhaft ablegt.
Die wichtigsten sind die Playlist Neural Networks: Zero to Hero, das Video Let's build GPT from scratch, der Überblick Intro to Large Language Models und der Deep Dive into LLMs like ChatGPT. Alle Kurse sind kostenlos und bauen auf lauffähigem Open Source Code auf. Für Einsteiger ist Zero to Hero der beste erste Schritt.
minbpe ist Karpathys minimale Python Implementierung des Byte Pair Encoding Tokenizers, wie ihn GPT Modelle und viele andere LLMs nutzen. Es erklärt, wie Text in Tokens zerlegt wird und warum Tokenisierung großen Einfluss auf Modellverhalten, Kontextlänge und Kosten hat. Wer Token Limits verstehen will, findet hier die Grundlage.
Karpathy prägte den Begriff Anfang 2025. Gemeint ist ein Stil, bei dem du dem LLM beschreibst, was du willst, und den generierten Code kaum noch selbst liest. In seinem Jahresrückblick 2025 schreibt er, dass Vibe Coding Software und Jobprofile verändern wird. Für Production braucht dieser Stil Tests, Review und klare Guardrails.
Ja. Das Verständnis von LLM Architekturen ist unabhängig von der Sprache und hilft direkt, wenn PHP Teams KI Funktionen integrieren: Prompt Design, Kontext Management, Auswahl lokaler Modelle über Ollama und Integration in Symfony Services. Auch das LLM Wiki Muster passt gut, um Projektwissen neben dem Code zu pflegen.
Karpathys Ressourcen sind auf karpathy.ai verlinkt. Seine Projekte liegen auf GitHub unter github.com/karpathy, der YouTube Kanal unter youtube.com/@AndrejKarpathy, sein Blog auf karpathy.bearblog.dev. Das LLM Wiki selbst ist ein Gist auf GitHub. Alle Ressourcen sind kostenlos zugänglich und werden laufend um neue Projekte ergänzt.