
Debugging lernen, Code verstehen, KI gezielt einsetzen. Persönliches Mentoring statt Bootcamp – in deinem Tempo.
Die NCA Python AI Coding Guidelines sind ein Regelwerk aus Rules Dateien, Spezifikationen, Tests und Quality Gates, das wir in bestehende Python Projekte einbauen. Es legt fest, wie ein KI Agent in eurem Code arbeiten darf und was erfüllt sein muss, bevor sein Ergebnis in den Hauptbranch geht.
Python macht es dem Agenten dabei besonders leicht, danebenzugreifen. Die Sprache nimmt fast alles an. Ein falscher Typ, ein vergessener None Fall, ein Dictionary mit einem Schlüssel, den es erst zur Laufzeit nicht gibt: Nichts davon fällt beim Schreiben auf. Es fällt auf, wenn der Job nachts durchläuft oder die Anfrage von einem echten Nutzer kommt.
Dazu kommt die Breite der Codebasis. In vielen Teams liegen Skripte, Notebooks, ein Service und ein paar Jobs im selben Repository, mit unterschiedlichem Alter und unterschiedlichen Konventionen. Ein Agent greift sich das erstbeste Muster, das er findet, und schreibt den nächsten Baustein genauso.
Diese Seite beschreibt die Python Ausprägung. Das sprachneutrale System dahinter, mit Prozessvertrag, persistentem Projektwissen und den fünf Ebenen, sind die NCA Agentic AI Coding Guardrails. Für PHP und Symfony gibt es die NCA PHP AI Coding Guidelines, für Astro, React und Vue die AI Coding Guidelines für TypeScript Projekte.
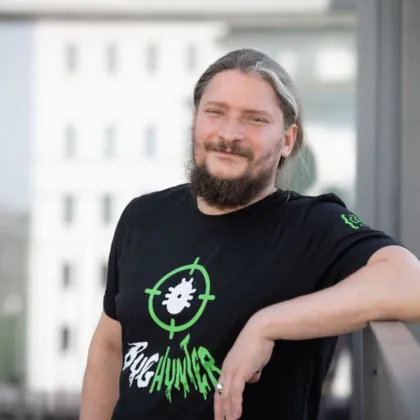
Roland Golla ist Entwickler aus Leidenschaft – seit über 20 Jahren. Er hat hunderte Projekte begleitet, von Legacy-Refactoring bis KI-Integration. Bei Vibe Coding verbindet er das Beste aus beiden Welten: Die Geschwindigkeit von KI-generiertem Code mit der Qualität professioneller Softwareentwicklung. Kein Bullshit, keine Agentur-Floskeln – direkte Hilfe von jemandem, der selbst täglich im Code steckt.
Wir starten bei eurem Code und nicht bei einem Konzeptpapier.
1. Codebasis lesen
Zuerst schauen wir, wie bei euch tatsächlich gearbeitet wird: Projektstruktur, Paketverwaltung, wie Abhängigkeiten festgehalten werden, wie viel typisiert ist und wie viel nicht. Dazu ein Blick auf Tests und Pipeline. Erst danach lässt sich sagen, wo Regeln überhaupt greifen können.
2. Regeln aus eurem Projekt ableiten
Die AGENTS.md beschreibt euer Projekt und nicht allgemeine Python Empfehlungen. Sie hält fest, wie bei euch Module geschnitten sind, wo Konfiguration und Secrets liegen, welche Bibliothek für welchen Zweck gesetzt ist und wie mit Fehlern umgegangen wird. Ein großer Teil der Wirkung kommt aus den Verboten: welche Pakete nicht mehr dazukommen und welche Bereiche der Agent gar nicht anfassen darf.
3. Spezifikationen statt flüchtiger Prompts
Zu jeder Änderung entsteht vorher ein kurzes Dokument mit Ziel und Akzeptanzkriterien, versioniert im Repository. Es überlebt die Sitzung, ist für alle im Team lesbar und ist im Review der Maßstab, an dem das Ergebnis gemessen wird.
4. Tests und Quality Gates
Selbsteinschätzung ist beim Agenten wenig wert, deshalb ersetzen Tests sie durch ein Kriterium, über das sich nicht diskutieren lässt. Ruff prüft Stil und eine große Zahl an Fehlermustern, mypy prüft Typen, pytest prüft das Verhalten. Diese drei laufen anschließend in der Pipeline und entscheiden, was gemergt wird. Die Typabdeckung ziehen wir schrittweise nach, statt das Projekt sofort auf strikte Prüfung zu zwingen.
5. Das Team übernimmt
Der Einbau läuft an einer echten Aufgabe aus eurem Backlog, in Pair Programming Sessions und gemeinsamen Reviews. Danach gehört das Ergebnis euch: offene Dateien im Repository, Open Source Werkzeuge, keine Plattform und kein Zugang, der ablaufen kann.
Im Python Werkzeugkasten hat sich in kurzer Zeit viel bewegt. Vier Punkte bestimmen, wie wir Guardrails heute aufsetzen.
Das Linting ist zum ernsthaften Tor geworden.
Ruff ist in Rust geschrieben und läuft auf großen Projekten in Sekunden statt Minuten. Mit Version 0.16 vom Juli 2026 sind über vierhundert Regeln standardmäßig aktiv. Das ändert die Rolle des Linters: Was früher ein nachgelagerter Stilcheck war, läuft jetzt nach jedem Agentenlauf mit und fängt einen Teil der Fehler ab, für die vorher ein Mensch lesen musste.
Die AGENTS.md ist ein echter Standard geworden.
Das Regelwerk liegt inzwischen unter der Agentic AI Foundation der Linux Foundation, zusammen mit dem Model Context Protocol, und steckt in knapp hunderttausend Repositories auf GitHub. Codex, Copilot und Cursor lesen dieselbe Datei. Claude Code liest weiterhin die CLAUDE.md und holt sich die gemeinsame Basis über eine Importzeile. Den Aufbau dieser Dateien beschreiben die Rules Dateien für KI Coding Agents.
Regeln sind Text, Hooks sind Zwang.
Eine Regel in der Markdown Datei ist eine Bitte, die ein Modell auch übergehen kann. Ein Hook ist ein Shell Befehl, der unabhängig vom Modell greift und einen Vorgang abbricht. Wir verdrahten den Hook am Ende des Agentenlaufs, den git Hook vor dem Commit und den Job in der Pipeline auf dasselbe Skript: Ruff, mypy, pytest. Ein Tor, drei Stellen, identisches Ergebnis. Die Mechanik dahinter steht bei den Quality Gates für KI Code.
Bei den Typprüfern kommt Bewegung auf.
In Produktion arbeiten wir mit mypy, weil es ausgereift ist und in jeder Pipeline läuft. Daneben steht mit ty ein in Rust geschriebener Prüfer von Astral, der deutlich schneller arbeitet, sich aber noch in der Beta befindet. Für Teams, bei denen die Prüfzeit heute wehtut, lohnt der Blick. Wir ordnen das im Projekt ein, statt pauschal zu wechseln. Was vor der Umsetzung festgehalten wird, beschreibt Spec Driven Development.
Sobald mehr als eine Person mit Agenten arbeitet, wird die Kostenfrage konkret. Diese Ebene ist nicht Python spezifisch, deshalb steht sie im Detail bei den NCA Agentic AI Coding Guardrails, dem sprachneutralen System hinter diesen Guidelines.
Kurz gefasst: LiteLLM steht als Proxy vor den Modellen, jeder Aufruf läuft darüber, egal ob lokal über Ollama oder in der Cloud. Verbrauch und Kosten liegen damit pro Nutzer und pro Projekt auf einem Dashboard, harte Budget Limits stoppen die Weiterleitung, wenn der Topf leer ist. Über dieselbe Stelle werden die MCP Server zentral vergeben.
Bei Python kommt ein Punkt dazu, den andere Stacks so nicht haben: In Data und Machine Learning Projekten liegen echte Daten oft direkt neben dem Code, in Notebooks, in Beispieldateien, in Zwischenständen. Deshalb legen wir früh fest, womit der Agent arbeiten darf. Gearbeitet wird gegen Testdaten, nicht gegen Bestände mit Personenbezug.
Für Teams, die vollständig ohne externe Anbieter arbeiten wollen, steht dahinter Self Hosted KI im Unternehmen mit Mandantentrennung und Audit Logging. Soll die Inferenz in Deutschland liegen, ohne eigene Hardware zu betreiben, arbeiten wir mit unserem Duisburger Netzwerkpartner Conversis zusammen, der gehostete Inferenz nach DSGVO Vorgaben anbietet.
Bei Never Code Alone beraten Entwickler, die selbst im Code arbeiten. Ruff, mypy und pytest gehören hier genauso zum Alltag wie Claude Code und OpenCode. Aus dieser Kombination kommt der Blick auf KI Code, der die Qualitätsseite nicht ausblendet.
Roland Golla ist der Gründer. Sein Thema: Die KI schreibt den Code, er sorgt für die Qualität. Automatisiertes Testen läuft bei uns seit 2013, er ist Cypress Ambassador. Was wir bei euch einbauen, läuft bei uns selbst in Produktion. Fällt beim Aufsetzen etwas Grundsätzliches auf, sagen wir es auch dann, wenn es unbequem wird.
Zu Aufwand, Zeitrahmen und Abrechnung steht alles bei den NCA Agentic AI Coding Guardrails. Kurz: kostenloses Kennenlernen, danach Aufwandsschätzung und minutengenaue Abrechnung.
Rund um die Guidelines greifen weitere Leistungen. Den Einstieg setzt das Vibe Coding Consulting, den Blick in gewachsenen KI Code das Codebase Audit für KI generierten Code, sicherheitskritische Bereiche das Vibe Coding Security Audit. Für Pipelines gibt es die CI CD Pipelines für Python Projekte und den Weg zu AI Code in Produktion. Wie wir KI Code in Python aufräumen, steht bei Python Refactoring und Qualität, die Methodik dahinter bei Exact Coding und in den Vibe Coding Best Practices.
Teams mit mehreren Stacks bekommen von uns ein gemeinsames Regelwerk statt getrennter Welten. Für das Backend in PHP gibt es die NCA PHP AI Coding Guidelines, für das Frontend die AI Coding Guidelines für TypeScript Projekte. Der Aufbau ist in allen drei derselbe, es wechseln nur die Werkzeuge.
The cost of putting up a plausible PR has gone to zero
Antworten auf die Fragen, die in Erstgesprächen am häufigsten kommen. Von der Typisierung über den Umgang mit Notebooks bis zu der Frage, wie lange die Einführung realistisch dauert.
Ein Regelwerk für die Zusammenarbeit mit KI Coding Agents im eigenen Projekt. Dazu gehören Rules Dateien wie AGENTS.md, eine Spezifikation je Änderung, Tests als Abnahmekriterium und automatische Prüfungen in der Pipeline. Ziel ist Code, der zum bestehenden Projekt passt und sich genauso reviewen und warten lässt wie handgeschriebener.
Dort besonders. In gewachsenen Codebasen liegen Skripte, Jobs und Services mit unterschiedlichem Alter nebeneinander, und ohne Vorgabe greift ein Agent gern das erstbeste Muster auf, das er findet. Mit klaren Regeln und einer Testbasis an den kritischen Stellen wird die Arbeit daran wieder planbar.
Ruff für Linting und Formatierung, mypy für die Typprüfung, pytest für Tests. Alles Open Source und alles im Repository. Dazu ein Agent eurer Wahl, meist Claude Code oder OpenCode, bei Bedarf mit lokalen Modellen über Ollama. Mehr braucht es für den Anfang nicht.
15 bis 30 Tage bis zum ersten belastbaren Stand: Regeln stehen, die ersten Gates laufen, der Agent arbeitet im Alltag mit. Am unteren Ende liegen Projekte mit Versionskontrolle, Tests und laufender Pipeline. Fehlen Tests und CI komplett, wird daraus ein längeres Vorhaben. Danach folgen ein paar Tage pro Monat für die Pflege.
Ja. Alle Artefakte sind offene Dateien im Repository. AGENTS.md wird von den meisten Agents gelesen, Claude Code nutzt zusätzlich CLAUDE.md. Spezifikationen, Tests und Pipeline arbeiten ohnehin unabhängig vom Werkzeug. Ein Wechsel des Agenten oder des Modells lässt die Guidelines unberührt.
Ja, und das ist der häufigste Ausgangspunkt. Wir typisieren nicht flächendeckend, sondern zuerst die Ränder: Eingaben von außen, Rückgabewerte öffentlicher Funktionen, die Stellen, an denen künftig KI Code entsteht. mypy läuft dabei zunächst nur über diese Bereiche und wächst mit.
Projektstruktur und Modulschnitt, die gesetzte Paketverwaltung und wie Abhängigkeiten dazukommen, der Umgang mit Konfiguration und Secrets, das Fehlerkonzept und die Testpflichten. Dazu die Verbote: welche Pakete nicht mehr verwendet werden und welche Bereiche der Agent nicht anfassen soll.
Notebooks sind für Agenten schwieriges Terrain, weil Reihenfolge und Zustand nicht im Code stehen. Wir ziehen deshalb die Grenze: Im Notebook wird exploriert, alles, was mehrfach gebraucht wird, wandert als getestete Funktion in ein Modul. Der Agent arbeitet an den Modulen, nicht an den Notebooks.
Auf Ebene des guten Willens gar nicht, denn ein Agent hält Regeln mal ein und mal nicht. Deshalb steht hinter jeder wichtigen Regel eine automatische Prüfung. Ruff, mypy und pytest laufen in der Pipeline, und was dort durchfällt, wird nicht gemergt.
Nein, sie verkürzen es. Formatierung, Typfehler und Standardverstöße fängt die Pipeline ab, bevor jemand hinschaut. Im Review bleibt die fachliche Frage, ob die Lösung richtig ist und ob die Entscheidung zum Projekt passt. Dafür ist dann mehr Zeit da.
Nicht pauschal. mypy ist ausgereift und läuft überall, ty ist deutlich schneller, aber noch in der Beta. Wenn die Prüfzeit bei euch heute wehtut, lohnt ein Versuch im Parallelbetrieb: beide laufen lassen, Ergebnisse vergleichen, erst danach entscheiden. Ein Wechsel des Prüfers lässt die Regeln unberührt.
Derselbe Aufbau, andere Schwerpunkte. Wichtig sind hier die Datenregeln: Der Agent arbeitet gegen Testdaten, nicht gegen echte Bestände, und Zugriffe laufen über definierte Werkzeuge statt über freie Verbindungen. Beim Testen zählt weniger die Abdeckung als die Frage, ob Ergebnisse reproduzierbar sind.
Ja. Eine schlanke Basisdatei liegt auf Wurzelebene, je Paket kommen eigene Regeldateien dazu. Der Agent lädt dann nur, was zum aktuellen Verzeichnis passt. Genauso wichtig: Prüfungen und Testsuite laufen je Paket, damit ein Fehler zeigt, wo er entstanden ist.
Wir arbeiten ohne Festpreise und ohne Pakete. Am Anfang steht ein kostenloses Kennenlernen, in dem wir euer Projekt und euer Ziel verstehen. Danach schätzen wir den Aufwand ein und rechnen minutengenau ab, sodass jederzeit nachvollziehbar bleibt, wofür ihr zahlt.
Ja. Der Aufbau ist sprachunabhängig, es wechseln nur die Werkzeuge. Für PHP und Symfony gibt es die NCA PHP AI Coding Guidelines mit PHPStan, Rector und PHPUnit, für Astro, React und Vue die Variante für TypeScript. Das sprachneutrale System hinter allen dreien sind die NCA Agentic AI Coding Guardrails.
Hier geht es um die Details: welche Werkzeuge an welcher Stelle greifen, was mit euren Daten passiert und woran ihr erkennt, ob sich die Einführung gelohnt hat.
Ja. Wir arbeiten selbst täglich mit Ollama und Modellen wie Qwen3 Coder auf eigener Hardware. Die Guidelines sind reine Dateien im Repository, denen es gleichgültig ist, welches Modell sie liest. Für Teams mit strengen Vorgaben ist das der Weg, bei dem kein Quellcode das eigene Netz verlässt.
Nein. Es gibt drei Wege: lokale Modelle über Ollama, gehostete Inferenz bei einem europäischen Anbieter oder eine Cloud eurer Wahl. Bei hohen Anforderungen arbeiten wir mit unserem Duisburger Netzwerkpartner Conversis zusammen, der gehostete Inferenz nach DSGVO Vorgaben anbietet.
Über LiteLLM als Proxy vor den Modellen. Jeder Aufruf läuft darüber, lokal wie in der Cloud, und landet mit Verbrauch und Kosten auf einem Dashboard. Darauf setzen Budgets je Nutzer, Team oder Projekt: Ist der Topf leer, leitet der Proxy nicht mehr weiter. Damit fällt ein durchlaufender Agent Loop sofort auf statt erst auf der Monatsrechnung.
Zentral über dieselbe Stelle. Wer welchen MCP Server erreichen darf, wird einmal vergeben statt in jeder lokalen Konfiguration einzeln gepflegt. Neue Kollegen bekommen den passenden Satz an Werkzeugen freigeschaltet, ohne dass Zugangsdaten per Chat weitergereicht werden.
So streng, wie die Codebasis es heute trägt, und dann schrittweise strenger. Ein Projekt sofort auf vollständige Prüfung zu zwingen erzeugt eine Fehlerliste, die niemand abarbeitet, und ein Gate, das dauerhaft rot steht. Solche Gates werden erfahrungsgemäß ignoriert.
Wir starten mit dem Standardsatz und nehmen gezielt dazu, was zum Projekt passt, etwa Regeln gegen stille Fehlerbehandlung oder gegen veraltete Schreibweisen. Was nur Lärm erzeugt, schalten wir bewusst ab und schreiben den Grund dazu. Eine Regel ohne Begründung wird beim nächsten Konflikt einfach wieder entfernt.
An der Grenze wird abgeschnitten. Externe Aufrufe laufen über eine schmale Schicht, die im Test ersetzt wird, damit die Suite ohne Netz läuft und reproduzierbar bleibt. Für den Ernstfall bleibt eine kleine Zahl an Tests gegen die echte Schnittstelle, die seltener läuft.
An Zahlen, die ohnehin vorliegen. Wie viele Kommentare hängen an einem Merge Request, wie lange bleibt er offen, wie oft geht ein Feature zurück in die Entwicklung, wie entwickelt sich die Testabdeckung. Wir sehen uns diese Werte vorher an, damit der spätere Vergleich etwas aussagt.
Euch. Alle Artefakte liegen als offene Dateien in eurem Repository, die Werkzeuge dahinter sind Open Source. Es gibt keine Plattform und keinen Zugang, der ablaufen kann. Ihr könnt das Ergebnis jederzeit ohne uns weiterentwickeln.
Immer dann, wenn sich eine Architekturentscheidung ändert oder ein neues Muster Einzug hält. In der Praxis sind das ein paar Zeilen pro Quartal. Wichtig ist, dass die Pflege im Team verankert ist, deshalb zeigen wir in den Sessions, wie eine Regel entsteht und wie sie wieder verschwindet.
Der Agent schreibt Migrationen, führt sie aber nicht gegen echte Bestände aus. Gearbeitet wird gegen eine lokale Entwicklungsumgebung mit Testdaten. Wo ein Agent an ein echtes System muss, läuft der Zugriff über definierte Werkzeuge statt über freien Datenbankzugang.
Die Regeln und Gates gelten für alle gleich, weil sie im Repository liegen und in der Pipeline laufen. Beim Agenten selbst hat jeder die freie Wahl. Wichtig ist nur, dass lokal dieselben Prüfungen laufen wie in der CI, sonst verschiebt sich die Fehlersuche in den Merge Request.
Beides. Der größte Teil läuft remote über Pair Programming Sessions und gemeinsame Reviews, was für die meisten Teams am besten funktioniert. Für Workshops und intensive Startphasen kommen wir auch vor Ort, von Duisburg aus in den gesamten DACH Raum.