Eliminierung technischer Schulden mit PHPStan, Rector PHP und PHPUnit. Über 20 Jahre Praxiserfahrung in skalierbaren Backends.
CORE EXPERTISE

Faker ist eine Open Source Library, die realistische Testdaten erzeugt: Namen, Adressen, Mails, Firmen, Preise, Datumswerte. Für lokale Entwicklung mit KI ist Faker der Baustein, der die Datenbank füllt, bevor der Agent den ersten Screen baut.
Die Library gibt es für alle großen Sprachen im Web. @faker-js/faker deckt JavaScript und TypeScript ab, ist MIT lizenziert und bringt über 70 Locales mit. FakerPHP/Faker ist das Pendant für PHP und Symfony Projekte. Faker für Python kommt als gleichnamiges Paket über pip und hat ein eigenes pytest Plugin. Alle folgen der gleichen Idee: statt Hans Müller und test@test.de erzeugst du Daten, die aussehen wie echte Daten.
Der Unterschied wird erst sichtbar, wenn ein KI Agent auf die Anwendung losgeht. Gegen eine leere Tabelle baut er Layouts, die bei drei Datensätzen kippen. Gegen zweihundert generierte Datensätze baut er etwas, das im echten Betrieb hält. Und auf Staging sieht die Abnahme dieselbe Welt wie die Entwicklung.
Never Code Alone arbeitet seit 2013 an automatisierten Tests. Roland Golla ist Cypress.IO Ambassador, und Testdaten sind der Punkt, an dem die meisten Setups schon vor dem ersten Test scheitern. Faker steckt bei uns in jedem Projekt: FakerPHP in Symfony, @faker-js/faker in Astro, React und Vue, Faker für Python neben pytest. Die Seeds laufen lokal und auf Staging gegen SQLite mit libSQL, MySQL und PostgreSQL. Die Daten stehen, bevor Claude Code oder OpenCode die erste Zeile schreiben.
Wir helfen Teams dabei, genau diesen Schritt sauber aufzusetzen. Passend dazu: unser Vibe Coding Consulting, der Codebase Audit für KI generierten Code, das CI/CD Pipeline Setup mit Staging, das 1:1 Mentoring für Vibe Coder sowie die Arbeit an Quality Gates für KI Code und Deployment Problemen zwischen lokal und Server. Wer sein Projekt bereits an die Wand gefahren hat, findet Hilfe unter Vibe Coding Projekt retten.
Eliminierung technischer Schulden mit PHPStan, Rector PHP und PHPUnit. Über 20 Jahre Praxiserfahrung in skalierbaren Backends.
Gesetzliche Konformität & Inklusion. Optimierung von Performance und Conversion durch radikal nutzerzentriertes, universelles Design.
Skalierbare KI-Systeme mit echtem Code Ownership. CI/CD, Backup-Strategien und Infrastruktur, die mit deinem Team wächst.
Ein KI Agent sieht keine Screenshots. Er sieht Code und das, was du ihm an Kontext gibst. Wenn die lokale Datenbank leer ist, fehlt ihm die wichtigste Rückmeldung überhaupt: wie sich die Anwendung mit Daten verhält.
Vier Fehlerklassen entstehen fast immer aus leeren oder zu braven Testdaten:
Das ist kein KI Problem im engeren Sinn. Es ist ein Kontextproblem. Wer Context Window Management ernst nimmt, füttert dem Agenten die Realität lieber als Daten in der Datenbank statt als lange Prosa im Prompt.
Ein Tag inhouse mit Roland Golla, offizieller Cypress Ambassador und seit über 20 Jahren in Testing und Refactoring zu Hause. Auf unserem YouTube Kanal zeigt er in über 70 Live Coding Tutorials, wie Cypress in echten Projekten läuft. Dazu kommt unser Open Source Plugin NCA TESTIFY: Basistests für jede Website, mit einer Zeile im CI/CD Setup. Im Workshop lernt euer Team Setup, stabile Selektoren, Custom Commands und Tests in der Pipeline.
Faker gehört in die Dev Dependencies. Die Library soll nie im Production Bundle landen.
npm install --save-dev @faker-js/faker
Der erste Aufruf zeigt sofort, warum die Daten besser sind als handgeschriebene Fixtures. Die Module heißen sprechend: person, internet, location, company, commerce, date, string.
          import { faker } from '@faker-js/faker';

export function createUser() {
  return {
    id: faker.string.uuid(),
    firstName: faker.person.firstName(),
    lastName: faker.person.lastName(),
    email: faker.internet.email(),
    company: faker.company.name(),
    city: faker.location.city(),
    createdAt: faker.date.past({ years: 2 }),
  };
}

const users = faker.helpers.multiple(createUser, { count: 200 });
Zweihundert Datensätze in acht Zeilen. Genau das ist der Punkt, an dem ein KI Agent anfangen kann, sinnvolle Komponenten zu bauen.
Wichtig für 2026: Faker 10 ist reines ESM. Wer noch CommonJS oder Jest ohne ESM Setup fährt, findet im Upgrade Guide des Projekts die passenden Schritte. Aktuell ist Version 10.5.0 vom 17. Juni 2026.
Zufällige Daten haben einen Haken. Wenn jeder Lauf andere Werte liefert, ist ein Bug nicht mehr nachstellbar, und der KI Agent bekommt bei jedem Durchlauf ein anderes Bild. Die Lösung heißt Seed.
          import { faker } from '@faker-js/faker';

faker.seed(123);
const first = faker.person.fullName();

faker.seed(123);
const second = faker.person.fullName();

console.log(first === second); // true
Mit festem Seed erzeugt jeder Entwickler und jeder CI Lauf exakt dieselben Datensätze. Ein Screenshot Test bleibt stabil, ein Bugreport bleibt nachvollziehbar, und der Agent sieht bei jedem Kontextaufbau dieselbe Welt.
Bei Datumswerten braucht es zusätzlich einen fixierten Referenzzeitpunkt, sonst wandern die Ergebnisse mit dem Kalender. Die Faker Dokumentation beschreibt das unter Reproducible Results. Wer Snapshot Tests fährt, sollte diesen Schritt nicht überspringen.
Für deutsche Projekte ist die englische Standard Locale die falsche Wahl. Ohne Umlaute im Datenbestand findest du Encoding Fehler erst dann, wenn ein Kunde sie meldet.
          import { de, de_AT, Faker } from '@faker-js/faker';

export const faker = new Faker({
  locale: [de, de_AT],
});

faker.person.fullName();      // z. B. Jürgen Schröder
faker.location.city();         // z. B. Gelsenkirchen
faker.location.zipCode();      // z. B. 47051
faker.company.name();
Die Reihenfolge im Array ist ein Fallback. Fehlt ein Datenfeld in der ersten Locale, greift Faker auf die nächste zurück. Über 70 Locales stehen zur Verfügung, deutschsprachig sind de, de_AT und de_CH abgedeckt.
Genau hier zahlt sich Faker doppelt aus: Umlaute im Testbestand decken Probleme in Datenbank Collation, URL Slugs, CSV Export und PDF Rendering auf, lange bevor sie teuer werden.
Ein Faker Aufruf im Test ist nett. Der eigentliche Hebel ist ein Seed Skript, das die lokale Datenbank in einem Befehl füllt. Bei NCA läuft das in Astro Projekten über Drizzle gegen SQLite mit libSQL.
          // scripts/seed.ts
import { faker } from '@faker-js/faker';
import { db } from '../src/db';
import { users, posts } from '../src/db/schema';

faker.seed(2026);

const userRows = faker.helpers.multiple(
  () => ({
    name: faker.person.fullName(),
    email: faker.internet.email(),
    role: faker.helpers.arrayElement(['admin', 'editor', 'viewer']),
  }),
  { count: 50 }
);

const inserted = await db.insert(users).values(userRows).returning();

const postRows = faker.helpers.multiple(
  () => ({
    title: faker.lorem.sentence(),
    body: faker.lorem.paragraphs(3),
    authorId: faker.helpers.arrayElement(inserted).id,
    publishedAt: faker.date.recent({ days: 90 }),
  }),
  { count: 300 }
);

await db.insert(posts).values(postRows);
npm run db:reset && npm run db:seed
Zwei Regeln machen den Unterschied. Erstens: Das Seed Skript gehört ins Repository, nicht in einen Ordner auf deinem Rechner. Zweitens: Reset und Seed laufen zusammen, damit der Zustand immer identisch startet.
Für einen KI Agenten ist das ein handfester Vorteil. Er kann die Anwendung nach jedem Umbau neu aufsetzen, ohne dass jemand von Hand Daten nachpflegt. Wer diesen Schritt automatisiert, vermeidet einen guten Teil der Probleme, die wir unter blindem Iterieren und Code Chaos beschrieben haben.
Cypress mit Cypress Cloud ist bei NCA gesetzt. Faker liefert dort die Daten für Formulare, Registrierungen und Suchfelder. Ein eigener Command hält die Tests lesbar.
          // cypress/support/commands.ts
import { faker } from '@faker-js/faker';

Cypress.Commands.add('userData', () => ({
  firstName: faker.person.firstName(),
  lastName: faker.person.lastName(),
  email: faker.internet.email(),
  street: faker.location.streetAddress(),
  zip: faker.location.zipCode(),
}));
          describe('Registrierung', () => {
  it('akzeptiert lange Namen mit Umlauten', () => {
    cy.userData().then((user) => {
      cy.visit('/registrieren');
      cy.get('[data-cy=firstName]').type(user.firstName);
      cy.get('[data-cy=lastName]').type(user.lastName);
      cy.get('[data-cy=email]').type(user.email);
      cy.get('[data-cy=submit]').click();
      cy.contains('Willkommen').should('be.visible');
    });
  });
});
Ein Hinweis aus der Praxis: In E2E Tests, die auf feste Assertions setzen, brauchst du einen Seed. Sonst wird der Test flaky, und flaky Tests sind schlimmer als keine Tests. Verwandte Werkzeuge findest du im NCA Glossar unter BackstopJS und Selenium.
Im PHP Umfeld übernimmt FakerPHP die Rolle. Das Paket ist der gepflegte Nachfolger des archivierten Originals von François Zaninotto und wird über Composer installiert.
composer require --dev fakerphp/faker
          use Faker\Factory;

$faker = Factory::create('de_DE');
$faker->seed(2026);

foreach (range(1, 200) as $i) {
    $user = new User();
    $user->setName($faker->name());
    $user->setEmail($faker->email());
    $user->setCity($faker->city());
    $entityManager->persist($user);
}

$entityManager->flush();
In Symfony Projekten landet das üblicherweise in einer Doctrine Fixture, die per Konsolenbefehl läuft. Zusammen mit Doctrine Migrations und DDEV hast du damit eine lokale Umgebung, die in Minuten steht.
Für die Testseite gilt dasselbe wie in JavaScript: PHPUnit profitiert von realistischen Daten, Functional Tests mit dem Symfony WebTestCase erst recht.
In Python Projekten heißt das Paket schlicht Faker. Es steht unter MIT Lizenz, bringt eine deutsche Locale mit und gehört wie in PHP und JavaScript in die Dev Dependencies, etwa in die dev Gruppe deiner pyproject.toml.
pip install Faker
Den Seed setzt du in Python auf der Klasse. Danach liefert jede Instanz reproduzierbare Werte.
          from faker import Faker

Faker.seed(2026)
fake = Faker("de_DE")

users = [
    {
        "name": fake.name(),
        "email": fake.email(),
        "city": fake.city(),
        "zip": fake.postcode(),
        "created_at": fake.date_time_between(start_date="-2y"),
    }
    for _ in range(200)
]
Für Tests bringt Faker ein eigenes pytest Plugin mit. Die Fixture faker steht ohne Import bereit. Locale und Seed steuerst du über die Fixtures faker_locale und faker_seed in der conftest.py.
          # conftest.py
import pytest

@pytest.fixture(scope="session")
def faker_locale():
    return ["de_DE"]

@pytest.fixture
def faker_seed():
    return 2026

# test_registrierung.py
def test_registrierung_mit_umlauten(faker):
    user = {"name": faker.name(), "email": faker.email()}
    assert "@" in user["email"]
So nutzen pytest und das Seed Skript dieselben Daten. Wie wir KI generierten Python Code zusätzlich mit Ruff und mypy absichern, steht unter Python Refactoring und Qualität. Die passende Pipeline beschreiben wir unter Python Vibe Coding mit CI/CD.
Faker endet bei uns nicht auf dem eigenen Rechner. Auf Staging laufen dieselben Seeds wie lokal, in PHP, JavaScript und Python. Wer abnimmt, klickt durch eine gefüllte Anwendung. Und kein echter Kundendatensatz verlässt dafür die Produktion.
Drei Punkte machen das Setup stabil:
Für die Abnahme ist das auch ein Datenschutzthema. Ohne Produktionsdump auf Staging entfällt die Frage, wer welche personenbezogenen Daten sehen darf. Wie wir Staging Umgebungen und Preview URLs aufsetzen, zeigt CI CD Pipeline mit Docker und Staging. Das Gesamtpaket liefert unser CI/CD Pipeline Setup. Mehr zu Testdaten im E2E Kontext steht im Cypress Glossar unter Testdaten in Cypress.
Faker ist kein Allheilmittel. Vier Punkte solltest du kennen, bevor du das Seed Skript ins Repository legst.
Generierte Daten können zufällig echt sein. Das Projekt weist ausdrücklich darauf hin: erzeugte Namen, Mails und Telefonnummern zielen auf Realismus, nicht auf offensichtliche Fälschung. Schick aus deinem Testsetup also niemals Mails oder SMS an generierte Adressen.
Fachliche Logik bildet Faker nicht ab. Eine Rechnungsnummer mit Prüfziffer, ein gültiger Vertragsstatus, eine plausible Bestellhistorie: das musst du selbst modellieren. Faker liefert die Hülle, die Fachlichkeit kommt von dir.
Ohne Seed keine Vergleichbarkeit. Snapshot und Screenshot Tests gegen ungeseedete Daten produzieren rote Builds ohne echten Fehler.
Faker gehört nicht in Production. Die Library ist eine Dev Dependency. Wenn sie im Build landet, hast du ein Bundle Problem und im schlechtesten Fall ein Sicherheitsproblem. Ein Blick auf Composer Audit und auf unsere Seite zu Sicherheitsrisiken bei KI generiertem Code lohnt sich hier.
Die meisten Teams setzen Faker zu spät ein: erst wenn die Tests geschrieben werden. Im KI Workflow gehört es an den Anfang.
Der Seed gehört außerdem in die Agentenregeln. Eine Zeile in der AGENTS.md oder rules.md genügt: Vor jeder größeren Änderung Datenbank zurücksetzen und neu seeden. Damit wird aus einer Konvention eine Regel, die der Agent selbst befolgt.
Wer diesen Ablauf mit Agentic Coding Patterns und sauberen Quality Gates kombiniert, bekommt reproduzierbare Ergebnisse statt Überraschungen im Deployment.
Generate massive amounts of fake data in the browser and node.js
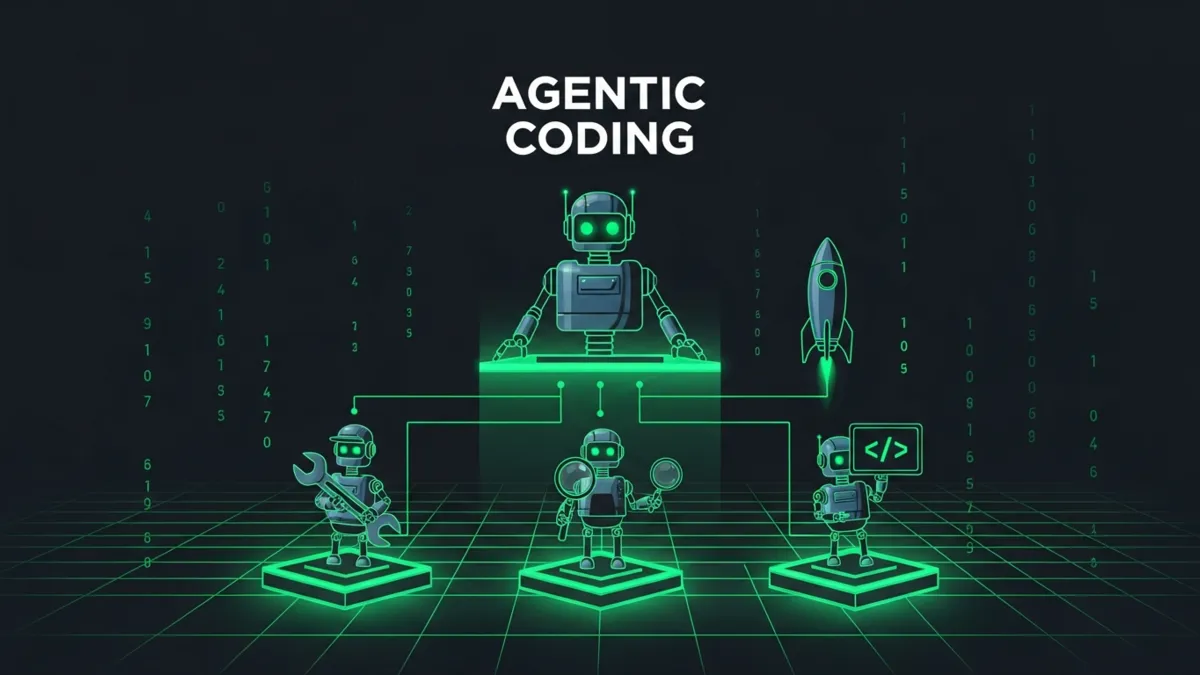
Agentic Coding Patterns: Die fünf Anthropic-Workflow-Muster für professionelle KI-Agenten. Prompt Chaining, Routing, Parallelisierung und Orchestrator-Workers.
Mehr erfahrenNever Code Alone kommt aus dem Testing. Seit 2013 dreht sich bei uns alles um Softwarequalität, und Testdaten sind dabei kein Nebenschauplatz, sondern die Grundlage. Roland Golla ist der Gründer von Never Code Alone in Duisburg. Sein Thema: Die KI schreibt den Code, er sorgt für die Qualität.
Faker nutzen wir in allen Projekten, egal ob PHP, JavaScript oder Python, und zwar lokal wie auf Staging. Die Seeds laufen gegen SQLite mit libSQL, MySQL und PostgreSQL. Cypress mit Cypress Cloud nutzt dieselben Daten wie die lokale Entwicklung. Auf der PHP Seite arbeiten wir mit PHPUnit, PHPStan, Psalm und Rector, auf der Python Seite mit pytest, Ruff und mypy.
Wenn du tiefer einsteigen willst: Der Weg vom Prototyp zur Produktion ist beschrieben unter Vibe Coding Hilfe. Wie du technische Schulden vermeidest, steht unter technische Schulden durch Vibe Coding. Für den Blick auf Grenzen lohnt sich Skalierbarkeit und Wartbarkeit. Eine Übersicht aller Themen findest du unter Vibe Coding Best Practices und im NCA PHP Glossar. Wer lokal sauber starten will, findet in DDEV und Docker die passende Basis, und in Git Interactive Rebase das Werkzeug für eine saubere History.
Wie viel Faker Daten für die EU KI Verordnung bringen, zeigen zwei Beiträge aus dem NCA Blog: EU AI Act Hochrisiko im Recruiting und EU AI Act Hochrisiko in der Bildung. In beiden Fällen entsteht der KI Helfer mit Fake Bewerbungen oder Fake Lernenden, lange bevor er echte Menschen bewertet.
Roland Golla ist Entwickler aus Leidenschaft – seit über 20 Jahren. Er hat hunderte Projekte begleitet, von Legacy-Refactoring bis KI-Integration. Bei Vibe Coding verbindet er das Beste aus beiden Welten: Die Geschwindigkeit von KI-generiertem Code mit der Qualität professioneller Softwareentwicklung. Kein Bullshit, keine Agentur-Floskeln – direkte Hilfe von jemandem, der selbst täglich im Code steckt.
Die Fragen, die uns zu Testdaten und Seeding im KI Workflow am häufigsten begegnen.
Faker ist eine Open Source Library, die realistische Testdaten erzeugt: Namen, Adressen, Mails, Firmen, Preise und Datumswerte. Du brauchst sie überall dort, wo eine leere Datenbank die Arbeit blockiert. In der lokalen Entwicklung, auf Staging, in automatisierten Tests und besonders dann, wenn ein KI Agent gegen die Anwendung arbeitet und echte Ausgaben sehen muss.
Aktuell ist @faker-js/faker in Version 10.5.0, veröffentlicht am 17. Juni 2026. Die Serie 10 ist reines ESM und hat die Deprecations aus Version 9 entfernt. Neu in 10.5.0 sind unter anderem die Generierung vollständiger Postadressen, Datumsbereiche für past und future sowie erste eigenständige Modulfunktionen.
Seit Version 10 liefert das Projekt nur noch ESM aus. Jest Setups ohne ESM Unterstützung laufen deshalb nicht mehr ohne Anpassung. Das Projekt dokumentiert die nötigen Schritte im Upgrade Guide. Wer nicht migrieren will, bleibt auf Version 9, verliert damit aber alle neuen Locales und Module.
Du importierst die Locale de und baust eine eigene Faker Instanz. Über ein Array aus mehreren Locales legst du zusätzlich einen Fallback fest, etwa de und de_AT. Damit bekommst du deutsche Namen, echte Straßennamen und gültige Postleitzahlen. Genau diese Daten decken Encoding Fehler in Datenbank, Slug und Export auf.
Ein KI Agent bewertet seine Arbeit an dem, was er sieht. Gegen eine leere Tabelle entstehen Layouts, die bei drei Datensätzen kippen. Gegen zweihundert generierte Datensätze entsteht Code, der Pagination, Sortierung und lange Werte berücksichtigt. Der Seed vor dem Agentenlauf ist damit einer der billigsten Qualitätsgewinne überhaupt.
Ja. Das Paket heißt Faker, wird über pip installiert und steht unter MIT Lizenz. Mit Faker de_DE bekommst du deutsche Daten, den Seed setzt du über Faker.seed. Für Tests bringt das Paket ein pytest Plugin mit einer faker Fixture mit. Locale und Seed steuerst du über faker_locale und faker_seed in der conftest.py.
Ja, wir machen das in allen Projekten. Auf Staging läuft derselbe Seed wie lokal, als eigener Schritt in der Pipeline nach dem Deployment. So klickt die Abnahme durch eine gefüllte Anwendung, ohne dass echte Kundendaten die Produktion verlassen. Wichtig: Mails auf Staging immer in einen Mailcatcher leiten und Faker nie im Production Build mitliefern.
Nichts. @faker-js/faker, fakerphp/faker und Faker für Python stehen unter MIT Lizenz und sind frei nutzbar, auch kommerziell. Kosten entstehen dir höchstens indirekt, wenn du das Seeding nicht sauber aufsetzt und dieselbe Arbeit später von Hand nachholst, etwa beim manuellen Befüllen von Staging vor jeder Abnahme.
Über einen festen Seed. In JavaScript mit faker.seed, in PHP mit $faker->seed, in Python mit Faker.seed. Danach liefert jede Sequenz identische Ergebnisse, auf jedem Rechner, in jedem CI Lauf und auf Staging. Bei Datumswerten brauchst du zusätzlich einen fixierten Referenzzeitpunkt, sonst werden Snapshot Tests rot ohne echten Fehler.
In die Dev Dependencies. Faker wird für lokale Entwicklung, Seeds, Tests und Staging gebraucht, nie für Production. Bei npm gilt --save-dev, bei Composer require --dev, in Python die dev Gruppe der pyproject.toml. Für Staging installiert ein eigener Seed Job die Dev Pakete, das Production Image bleibt schlank.
Die Idee ist identisch, die Ökosysteme unterscheiden sich. @faker-js/faker deckt JavaScript und TypeScript ab. FakerPHP/Faker ist der gepflegte Nachfolger des archivierten Originals und passt zu Symfony und Doctrine Fixtures. Faker für Python integriert sich direkt in pytest. Die deutsche Locale heißt in PHP und Python de_DE, in JavaScript de.
Nein. Das Projekt weist ausdrücklich darauf hin, dass die erzeugten Daten realistisch aussehen sollen und deshalb zufällig echt sein können. Eine generierte Mailadresse oder Telefonnummer kann einem echten Menschen gehören. Testmails gehören deshalb lokal wie auf Staging in einen Mailcatcher, nicht in den echten Versand.
Genug, damit Pagination, Sortierung und Filter greifen. Fünf Datensätze reichen nie. Ein paar hundert sind für die meisten Listenansichten ein guter Startwert, für Performance Fragen eher ein paar tausend. Wichtig ist die Bandbreite: sehr kurze und sehr lange Werte, damit Layoutfehler früh auffallen.
Für Entwicklung und Staging ja, für Lasttests nur bedingt. Generierte Daten bilden Verteilungen und fachliche Zusammenhänge nicht ab, wie sie im echten Betrieb entstehen. Ein Dump bringt diese Realität mit, dafür aber auch rechtlichen Aufwand. Wir fahren lokal und auf Staging Faker, ein anonymisierter Dump ist höchstens für gezielte Lasttests sinnvoll.