Eliminierung technischer Schulden mit PHPStan, Rector PHP und PHPUnit. Über 20 Jahre Praxiserfahrung in skalierbaren Backends.
CORE EXPERTISE

GLM 5.2 und GLM 5.3 sind die aktuellen Coding Modelle von Zhipu AI (Z.ai). GLM 5.2 kam am 13. Juni 2026 mit einem nutzbaren Kontextfenster von einer Million Token, GLM 5.3 folgte am 14. August 2026 auf exakt derselben Basis und holt seine gesamte Mehrleistung allein aus dem Post Training.
Stand Oktober 2026: GLM 5.3 ist das aktuelle Flaggschiff der Reihe. Z.ai misst rund 50 Prozent mehr Coding Leistung als bei GLM 5.2 und stellt Cyber Defense als zweiten Schwerpunkt daneben. Seit dem 28. August 2026 liegen auch die Gewichte offen auf Hugging Face, allerdings unter einer eigenen GLM 5.3 Lizenz. GLM 5.2 bleibt unter MIT Lizenz. Dazu kamen GLM 5.3 Flash und die schnelle API Variante FlashX.
Technisch baut GLM 5.2 auf der Architektur von GLM 5 auf: ein Mixture of Experts Modell mit 744 Milliarden Parametern, von denen pro Token rund 40 Milliarden aktiv sind. GLM 5.3 nutzt genau dieses Basismodell weiter. Damit reiht sich die Reihe in die schnelle Modellfolge von Z.ai ein, zu der auch GLM 5 Turbo gehört.
Wichtig für eine ehrliche Einordnung: Bei GLM 5.2 hat Zhipu zum Launch keine eigenen Benchmarks veröffentlicht. Erst über Artificial Analysis und Unsloth kamen Vergleichszahlen, die das Modell in vielen Disziplinen auf Augenhöhe mit Claude Opus 4.8, GPT 5.5 und Gemini 3.1 Pro sehen. Bei GLM 5.3 lagen die Zahlen am Launchtag vor, allerdings komplett aus eigener Messung. Unabhängige Nachmessungen stehen in beiden Fällen weiter aus, deshalb bewerten wir vorsichtig.
Bei Never Code Alone setzen wir voll auf chinesische Open Weight Modelle. GLM 5 Turbo läuft über Z.ai produktiv in unserem Stack, lokal fahren wir Qwen3 Coder und MiniMax über Ollama. Wir sind überzeugt: Open Weights unter MIT Lizenz, ohne US Abhängigkeit, sind für professionelle Entwicklung die stärkste Basis. Und wir lernen täglich dazu, weil wir genau diese Modelle jeden Tag im echten Projekt einsetzen.
GLM 5.2 reiht sich genau in diesen Kurs ein, und jede neue Version nehmen wir sofort in die Hand. Welches Modell zu welchem Workflow passt, klären wir im Vibe Coding Consulting, verankern bewährte Vibe Coding Best Practices in euren Prozessen und richten lokale KI Stacks ohne US Anbieter ein. Wer GLM 5.2 mit Agents wie Claude Code, OpenCode oder Crush einsetzen will, bekommt von uns eine fundierte Einordnung aus täglicher Praxis.
Eliminierung technischer Schulden mit PHPStan, Rector PHP und PHPUnit. Über 20 Jahre Praxiserfahrung in skalierbaren Backends.
Gesetzliche Konformität & Inklusion. Optimierung von Performance und Conversion durch radikal nutzerzentriertes, universelles Design.
Skalierbare KI-Systeme mit echtem Code Ownership. CI/CD, Backup-Strategien und Infrastruktur, die mit deinem Team wächst.
Am 14. August 2026 hat Z.ai GLM 5.3 veröffentlicht, gut zwei Monate nach GLM 5.2. Das Besondere daran: Das Basismodell bleibt unangetastet. Z.ai nutzt exakt die Basis von GLM 5.2 und holt den kompletten Zuwachs aus skaliertem Post Training. Kein neues Pre Training, keine neue Architektur, keine höhere Parameterzahl.
Der Slogan von Z.ai fasst die Ausrichtung zusammen: gebaut zum Programmieren, bereit für Cyber Defense. Wer die Reihe seit GLM 5 verfolgt, sieht hier den ersten Release, bei dem Z.ai über Training argumentiert und die Größe gleich bleibt.
Seit dem Start im August hat Z.ai die Reihe geöffnet und zweimal erweitert. Vier Punkte zählen für Teams:
Für die Praxis ist die Lizenz der wichtigste neue Punkt. Für interne Nutzung über eine gehostete Inferenz ändert die Klausel wenig. Wer ein eigenes Produkt auf den Gewichten baut oder sie weitergibt, liest die Lizenzdatei vorher genau. GLM 5.2 und GLM 5.3 Flash bleiben unter MIT und damit die unkompliziertere Wahl für eigene Hosting Setups bei europäischen Anbietern.
Z.ai hat zum Launch eine eigene Benchmark Übersicht veröffentlicht. Alle Zahlen stammen vom Hersteller, unabhängige Nachmessungen fehlen bisher. Der Vergleich mit der Vorgängerversion ist trotzdem aufschlussreich, weil beide Modelle auf derselben Basis laufen. Die Differenz zeigt also, was reines Post Training bewirkt.
Ein Modell mit über 740 Milliarden Parametern stellt sich niemand in den Serverraum. Die Hardware dafür liegt im hohen sechsstelligen Bereich und rechnet sich für kein normales Entwicklerteam. Unsere Regel lautet deshalb: Coding kommt aus der Cloud, die Datenverarbeitung bleibt im eigenen Netz. Gearbeitet wird gegen lokale Dev Umgebungen mit Fake Daten, für die Inferenz gibt es EU souveräne Anbieter wie TensorX oder unseren Netzwerkpartner Conversis in Duisburg. Wie das sauber aufgesetzt wird, zeigen wir in der Beratung zu souveräner KI im Unternehmen.
Offene Gewichte gibt es bei GLM 5.3 inzwischen, die Lizenz ist aber eine andere. Compliance kommt ohnehin aus dem Betriebsweg: Vertrag, Serverstandort, Zero Data Retention und die Frage, welche Daten überhaupt zum Modell gehen. Offene Gewichte liefern etwas anderes: Anbieterwahl statt Lock in, Schutz davor, dass ein Modell abgeschaltet oder still ausgetauscht wird, Preisdruck durch Wettbewerb und reproduzierbar prüfbares Verhalten. Das gilt für GLM 5.2 und GLM 5.3 gleichermaßen. Wer auf den Gewichten von GLM 5.3 ein eigenes Produkt baut, prüft zusätzlich die GLM 5.3 Lizenz.
Der zweite Punkt ist der spannendere. Der komplette Sprung kommt aus dem Post Training, nicht aus mehr Rechenleistung. Das deckt sich mit dem, was wir in Projekten sehen: Ein Modellwechsel bringt selten so viel wie ein sauberes Setup drumherum. Wer OpenCode mit klaren Regeln, Tests und Guardrails fährt, holt aus Qwen3 Coder oder GLM 5.2 heute mehr heraus als aus einem Versionssprung ohne Struktur. Die passenden Vibe Coding Best Practices sind dafür der Hebel. Für die Sicherheitsseite, die Z.ai mit dem verzögerten Release selbst betont, greift unser Vibe Coding Security Audit.
Ein Tag inhouse mit Benjamin Klein für Developer, Tester und Admins. Context Engineering, Harness, ADRs und zwei Hands on Blöcke mit KI Agenten in eurem Setup.

Zur Einordnung noch einmal der Stand von GLM 5.2. Das Modell war kein kompletter Neubau, sondern ein fokussiertes Upgrade der GLM 5 Linie. Diese Punkte waren beim Launch am 13. Juni 2026 bestätigt:
Belastbare Benchmarks lieferte Z.ai damals erst mit Verzögerung nach. Genau dieser Punkt hat sich mit GLM 5.3 geändert: Diesmal lagen die eigenen Zahlen am Launchtag auf dem Tisch, unabhängige Nachmessungen stehen aber weiter aus.
Z.ai hat die GLM 5 Linie in wenigen Monaten mehrfach erweitert. Die folgende Tabelle ordnet alle vier Modelle ein, mit Fokus auf die Eigenschaften, die im Alltag zählen: Kontextfenster, Ausrichtung und Release.
Der Sprung auf eine Million Token ist mehr als eine größere Zahl. Z.ai betont, dass das Fenster nutzbar bleibt, also über die gesamte Länge eine hohe Trefferquote und Kohärenz behält. Genau daran scheitern viele Modelle mit nominell großem Kontext.
Praktisch passen ganze Repositories, lange Logdateien oder mehrstufige Agent Sessions in einen Durchgang, ohne ständiges Nachladen. Für lange Aufgaben mit vielen Schritten ist das der Unterschied zwischen einem Agent, der den roten Faden behält, und einem, der nach der Hälfte den Kontext verliert. Vergleichbare 1M Ansätze gibt es etwa bei MiniMax M3.
GLM 5.2 bringt zwei Reasoning Stufen statt einer. High liefert schnellere Antworten, Max denkt länger und gründlicher. Für Coding empfiehlt Z.ai ausdrücklich Max, weil komplexe, mehrstufige Arbeit von tieferem Reasoning profitiert.
In Claude Code lässt sich die Stufe über den Effort Befehl steuern. Wer mit Agent Frameworks arbeitet, sollte die Voreinstellung bewusst wählen: Bei langen Tasks zahlt sich Max meist aus, bei schnellen Iterationen reicht High.
GLM 5.2 ist über den GLM Coding Plan nutzbar, auf allen Stufen von Lite bis Team. Dazu kommen API, der Z.ai Chatbot und die offenen Gewichte unter MIT Lizenz. Die Gewichte machen GLM 5.2 zu einem Modell, das jeder Anbieter hosten darf. Für dich heißt das: Du kannst eine europäische Inferenz wählen und bist nicht an Z.ai gebunden.
Bei GLM 5.3 lief es gestaffelt. Das Modell startete am 14. August nur über API und Coding Plan, die Gewichte folgten am 28. August nach einem zusätzlichen Safety Hardening. Der Unterschied liegt in der Lizenz: GLM 5.3 nutzt eine eigene Lizenz, nach der Anbieter mit sehr hohem Jahresumsatz eine Sicherheitsprüfung durch Z.ai brauchen. GLM 5.2 und GLM 5.3 Flash stehen unter MIT.
Out of the box arbeitet die GLM Reihe mit den gängigen Coding Agents zusammen, darunter OpenCode, Claude Code und Crush. Für Teams, die bewusst ohne US Anbieter arbeiten, ist ein chinesisches Open Weights Modell wie GLM 5.2 eine ernsthafte Option neben Qwen3 Coder Next und MiniMax M2.5.
Mit den offenen Gewichten gibt es GLM 5.2 auch als GGUF. Das volle Modell belegt rund 1,51 TB Speicher. Über die dynamischen Quantisierungen von Unsloth schrumpft das deutlich, die 2 Bit Variante UD IQ2 M kommt mit etwa 239 GB aus. Technisch läuft das über llama.cpp und Unsloth Studio, mit MoE Offloading sogar auf einer einzelnen 24 GB GPU plus 256 GB RAM.
Für produktives Coding ist das trotzdem kein Weg. Eine 2 Bit Quantisierung kostet Qualität, die Geschwindigkeit reicht nicht für lange Agent Sessions, und ein Server, der das volle Modell sauber betreibt, kostet einen hohen sechsstelligen Betrag. Unsere Regel bleibt: Coding kommt aus der Cloud, über eine europäische Inferenz wie TensorX oder Conversis. Lokal laufen bei uns kleine Modelle wie Qwen3 Coder über Ollama, für Datenverarbeitung im eigenen Netz. Wie das zusammenspielt, klären wir in der Vibe Coding Beratung.
Seit dem Launch liegen über Artificial Analysis und Unsloth erste Vergleichszahlen vor. Sie sehen GLM 5.2 als derzeit stärkstes offenes Modell, in vielen Disziplinen auf Augenhöhe mit Claude Opus 4.8, GPT 5.5 und Gemini 3.1 Pro. Wichtig bleibt die ehrliche Einordnung: Das sind Werte aus Drittquellen, keine offiziellen Z.ai Benchmarks. Die folgende Auswahl stellt GLM 5.2 den Werten von Claude Opus 4.8 gegenüber.
Zhipu positioniert GLM 5.2 in der offiziellen Ankündigung als neues Flaggschiff mit drei Kernversprechen: starke Coding Fähigkeiten, nutzbarer 1M Kontext und anhaltende Stärke bei langen Aufgaben.
GLM 5.2 liefert laut Z.ai „powerful coding capabilities, usable 1M-context support, and continued strengths in long-horizon tasks“.
– Z.ai, offizielle Ankündigung, 13. Juni 2026
Diese Aussagen sind Herstellerangaben. Eigene Benchmarks hat Z.ai erst mit Verzögerung nachgereicht, Drittquellen wie Artificial Analysis und Unsloth haben die Lücke gefüllt. Eine vollständig unabhängige Bewertung steht weiter aus.

GLM-5 von Zhipu AI im Business-Check: 744B Parameter, MIT-Lizenz, 5-8× günstiger als Claude. Kosten, Benchmarks und Einsatzszenarien für Unternehmen 2026.
Mehr erfahrenNever Code Alone hostet auf eigenen Servern in Deutschland und setzt bei KI voll auf chinesische Open Weight Modelle. GLM, Qwen3 Coder und MiniMax laufen bei uns täglich: große Modelle über gehostete Inferenz, kleine lokal über Ollama. Wir sind von diesem Weg überzeugt und lernen jeden Tag dazu, an echten Projekten mit echten Codebasen.
Genau deshalb nehmen wir ein Modell wie GLM 5.2 sofort in den Praxistest, statt auf Benchmarks zu warten. Wenn du GLM 5.2 oder Alternativen wie Qwen3 Coder Next, DeepSeek oder Kimi und Qwen einordnen willst, helfen wir im Vibe Coding Consulting und mit klaren Best Practices. Einen vollständigen Überblick bietet unsere Vibe Coding Modelle Übersicht, inklusive Guide für die Auswahl ohne US Anbieter.
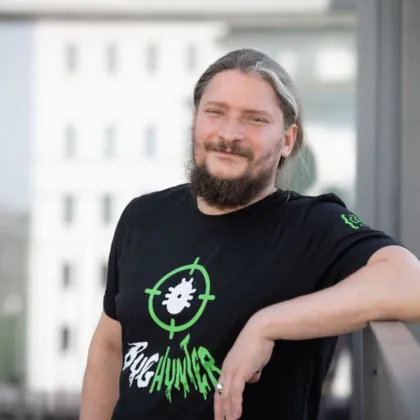
Roland Golla ist Entwickler aus Leidenschaft – seit über 20 Jahren. Er hat hunderte Projekte begleitet, von Legacy-Refactoring bis KI-Integration. Bei Vibe Coding verbindet er das Beste aus beiden Welten: Die Geschwindigkeit von KI-generiertem Code mit der Qualität professioneller Softwareentwicklung. Kein Bullshit, keine Agentur-Floskeln – direkte Hilfe von jemandem, der selbst täglich im Code steckt.
Die wichtigsten Fragen aus der Praxis zu beiden Modellen, kurz und ohne Marketing beantwortet.
GLM 5.2 ist ein Coding Modell von Zhipu AI (Z.ai), veröffentlicht am 13. Juni 2026. Es baut auf der GLM 5 Architektur mit 744 Milliarden Parametern auf und bringt als zentrale Neuerung ein nutzbares Kontextfenster von einer Million Token. Z.ai positioniert das Modell als Coding First Flagship für lange, agentische Aufgaben.
GLM 5.2 unterstützt ein nutzbares Kontextfenster von einer Million Token, gegenüber 200.000 Token bei GLM 5 und GLM 5 Turbo. Die Model ID des vollen Fensters lautet glm-5.2[1m]. Der maximale Output liegt bei 131.072 Token, genug für Diffs auf Pull Request Größe und lange agentische Ausführungs Traces.
Ja. Die Gewichte von GLM 5.2 liegen unter MIT Lizenz offen auf Hugging Face, veröffentlicht kurz nach dem Launch im Juni 2026. Damit darf jeder Anbieter das Modell hosten, auch europäische Inferenzanbieter. GLM 5.3 hat dagegen eine eigene Lizenz mit Sicherheitsprüfung für sehr große Anbieter.
GLM 5.2 ist ohne Aufpreis in allen Stufen des GLM Coding Plan enthalten, von Lite über Pro und Max bis Team. Dazu gibt es die API mit Abrechnung pro Token und gehostete Varianten bei Drittanbietern. Die aktuellen Konditionen legt der jeweilige Anbieter fest und sie ändern sich oft, deshalb nennen wir hier keine Zahlen.
Es gibt drei. GLM 5.3 ist das Flaggschiff auf Basis von GLM 5.2, mit offenen Gewichten unter eigener Lizenz. GLM 5.3 Flash ist kleiner, nativ multimodal und steht unter MIT Lizenz. GLM 5.3 FlashX ist eine schnelle API Variante von Flash mit laut Z.ai bis zu 200 Token pro Sekunde, ohne offene Gewichte und ohne eigene Benchmarks.
GLM 5.2 erweitert das Kontextfenster von 200.000 auf eine Million Token und führt zwei Thinking Effort Stufen ein. Die Basis bleibt die GLM 5 Architektur mit 744 Milliarden Parametern und 40 Milliarden aktiven Parametern pro Token. GLM 5.2 ist als fokussiertes Upgrade zu verstehen, nicht als komplett neues Modell.
GLM 5 Turbo wurde speziell auf OpenClaw Agent Workflows trainiert und arbeitet mit 200.000 Token Kontext. GLM 5.2 ist breiter als Coding First Flagship positioniert und bietet das deutlich größere 1M Kontextfenster. Für sehr lange Repository weite Aufgaben spielt GLM 5.2 seine Kontextgröße aus, während Turbo auf stabile Tool Aufrufe in Agent Ketten optimiert ist.
GLM 5.2 bietet zwei Reasoning Stufen: High für schnellere Antworten und Max für längeres, gründlicheres Denken. Für Coding empfiehlt Z.ai ausdrücklich die Stufe Max, weil komplexe, mehrstufige Arbeit von tieferem Reasoning profitiert. In Agent Frameworks lohnt es sich, die Voreinstellung je nach Aufgabe bewusst zu wählen.
GLM 5.2 ist out of the box mit gängigen Coding Agents kompatibel, darunter OpenCode, Claude Code, Cline, Roo Code, Goose, Crush, OpenClaw und Kilo Code. Für bestehende GLM Coding Plan Abonnenten genügt meist eine Änderung der Umgebungsvariablen, um vom Vorgänger auf GLM 5.2 zu wechseln.
Technisch ja, praktisch für die wenigsten Teams. 744 Milliarden Parameter brauchen Hardware im sechsstelligen Bereich, das rechnet sich fast nie. Unsere Regel lautet deshalb: Coding kommt aus der Cloud, die Datenverarbeitung bleibt im eigenen Netz. Lokal über Ollama fahren wir kleinere Modelle wie Qwen3 Coder, für die großen Modelle nutzen wir gehostete Inferenz.
GLM 5.2 ist ein chinesisches Open Weights Modell und damit eine ernsthafte Option für Teams, die bewusst auf US Anbieter verzichten. Entscheidend ist der Betriebsweg: Das Coding läuft über EU souveräne Inferenz, gearbeitet wird gegen lokale Dev Umgebungen mit Fake Daten, die Datenverarbeitung bleibt im eigenen Netz. NCA berät zur Auswahl zwischen GLM, Qwen und MiniMax je nach Use Case.
GLM 5.3 nutzt dasselbe Basismodell wie GLM 5.2. Der gesamte Zuwachs kommt aus skaliertem Post Training. Z.ai misst rund 50 Prozent mehr Coding Leistung auf der eigenen Code Bench, Terminal Bench 3.0 springt von 4,6 auf 28,3 Prozent. Dazu kommt ein neuer Schwerpunkt auf Cyber Defense mit 84,5 Prozent auf CyberGym. Alle Zahlen stammen bisher vom Hersteller.
Über gehostete Inferenz, nicht über eigene Hardware. Ein Modell dieser Größe im Serverraum kostet einen sechsstelligen Betrag und rechnet sich für kaum ein Team. Die Regel lautet: Coding kommt aus der Cloud, die Datenverarbeitung bleibt im eigenen Netz. Gearbeitet wird gegen lokale Dev Umgebungen mit Fake Daten, für die Inferenz gibt es EU souveräne Anbieter.
Das hängt von der Aufgabe ab. In der Messung von Z.ai erreicht GLM 5.3 auf der Reasoning Stufe High eine höhere Genauigkeit als Claude Opus 4.8 und braucht dafür deutlich weniger Output Token. Eine Bewertung des US Center for AI Standards and Innovation sieht die Cyber Fähigkeiten über Kimi K3, aber unter den aktuellen US Frontier Modellen.
Ja, seit dem 28. August 2026. Z.ai hatte die Freigabe wegen der gewachsenen Fähigkeiten bei der Schwachstellensuche um zwei Wochen verschoben und vorher eine Sicherheitsprüfung durchgeführt. Die Gewichte liegen auf Hugging Face, allerdings unter einer eigenen GLM 5.3 Lizenz. Anbieter mit sehr hohem Jahresumsatz brauchen danach eine Prüfung durch Z.ai.