Eliminierung technischer Schulden mit PHPStan, Rector PHP und PHPUnit. Über 20 Jahre Praxiserfahrung in skalierbaren Backends.
CORE EXPERTISE
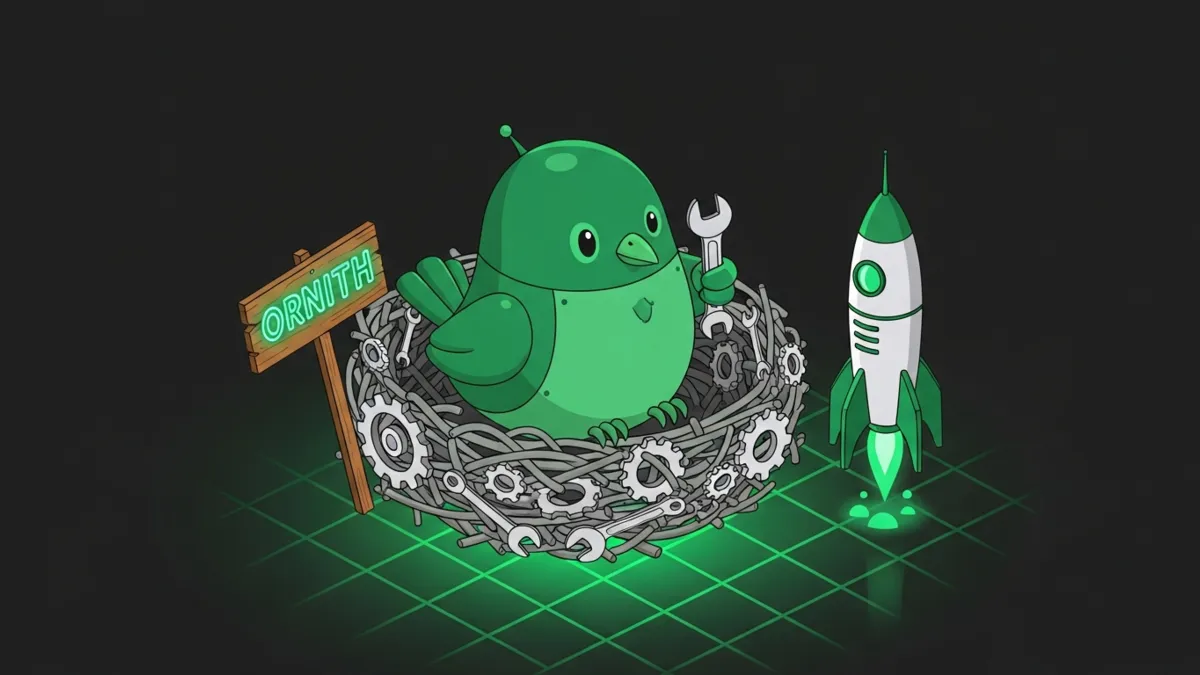
Ornith 1.0 ist eine Familie offener Coding Modelle von DeepReinforce, veröffentlicht im Juni 2026 unter MIT Lizenz. Die Besonderheit: Das Modell lernt im Training nicht nur, Code zu schreiben, sondern auch, sich den Arbeitsablauf dafür selbst zu bauen.
Der Name kommt vom altgriechischen Wort für Vogel. Es gibt vier Größen, von 9B für lokale Hardware bis 397B für eigene Rechenzentren. Basis sind Gemma 4 und Qwen 3.5. Alle Varianten haben ein Kontextfenster von rund 256K Token, über Ollama lassen sich zwei davon mit einem Befehl starten.
Für Teams, die ohne US Anbieter arbeiten wollen, ist das ein ernsthafter Kandidat: offene Gewichte, freie Lizenz, Betrieb auf eigener Hardware. Was das Modell wirklich kann und wo der Begriff self improving in die Irre führt, ordnen wir hier ein.
Never Code Alone arbeitet in Duisburg seit über zwanzig Jahren an Software Qualität. Lokale KI Modelle laufen bei uns täglich über Ollama, dazu Qwen3 Coder, Llama, GLM-5V Turbo über Z.AI und MiniMax. Wir kennen den Unterschied zwischen einer guten Benchmark Zahl und einem Modell, das im echten Repository trägt. Und wir sagen es, wenn ein neues Modell für dein Team nichts ändert.
Bei der Einordnung neuer Modelle helfen wir im Vibe Coding Consulting, beim Auswählen ohne US Anbieter, mit den Best Practices für KI-gestützte Entwicklung und beim Vergleich lokaler Coder Modelle. Dazu kommt das, was jedes KI Projekt trägt: automatisierte Tests mit Cypress und Quality Gates für KI Code, die Fehler finden, bevor der Kunde sie sieht.
Eliminierung technischer Schulden mit PHPStan, Rector PHP und PHPUnit. Über 20 Jahre Praxiserfahrung in skalierbaren Backends.
Gesetzliche Konformität & Inklusion. Optimierung von Performance und Conversion durch radikal nutzerzentriertes, universelles Design.
Skalierbare KI-Systeme mit echtem Code Ownership. CI/CD, Backup-Strategien und Infrastruktur, die mit deinem Team wächst.
Jeder Coding Agent besteht aus zwei Teilen. Dem Modell, das Code schreibt. Und dem Gerüst drumherum, das entscheidet, welches Tool wann aufgerufen wird, wann ein Versuch wiederholt wird und wie eine große Aufgabe in kleine zerfällt. Dieses Gerüst heißt Scaffold.
Bei Claude Code, OpenCode, Cursor und praktisch allen anderen Agenten bauen Menschen dieses Gerüst. Entwickler testen Varianten und optimieren Abläufe. Es ist Handarbeit, und sie wird nie fertig.
Ornith dreht das um. Das Scaffold ist kein festes Bauteil mehr, sondern wird im Training mitgelernt. Das Modell baut sich sein Arbeitsgerüst selbst und verbessert es Runde für Runde. Daher der Name: ein Vogel, der sein Nest aus den Teilen baut, die er findet.
Hier lohnt sich Genauigkeit. Ornith verbessert sich nicht bei dir im Betrieb. Die Gewichte, die du herunterlädst, bleiben, wie sie sind. Der Begriff bezieht sich auf das Training bei DeepReinforce.
Dort läuft jeder Reinforcement Learning Schritt in zwei Stufen:
Die Belohnung fließt in beide Stufen zurück. Über viele Runden setzen sich die besseren Ablaufstrategien durch.
Das Ergebnis ist ein Modell, das mehr Orchestrierung mitbringt. Es plant Schritte, ruft Tools auf, prüft Zwischenergebnisse und schreibt fehlgeschlagene Schritte neu. Wer aber ein Modell erwartet, das im Alltag dazulernt, wird enttäuscht. Diese Unterscheidung sauber zu treffen, gehört zu unserer Arbeit in der Vibe Coding Beratung.
Ornith kommt nicht als ein Modell, sondern als Familie. Vier Varianten decken die Spanne von lokaler Hardware bis Frontier Größe ab. Alle stehen unter MIT Lizenz auf Hugging Face, ohne regionale Sperren.
DeepReinforce nennt diese Werte:
Die kleine 9B Variante liegt damit laut Anbieter nah an deutlich größeren Modellen.
Diese Zahlen kommen vom Hersteller. Und SWE Bench hat bekannte Schwächen. Die Studie SWE ABS aus März 2026 fand, dass rund jeder fünfte als gelöst markierte Patch der Top Agents semantisch falsch ist. Ein hoher Score heißt also nicht, dass der Code richtig ist. Er heißt, dass die Tests durchlaufen.
Für dein Team zählt eine andere Zahl: Wie viele deiner echten Tickets löst das Modell sauber? Das misst niemand für dich. Wie du den Nutzen strukturiert misst, zeigt KI Coding ROI.
Der Einstieg ist kurz. Ollama installiert, Modell gezogen, fertig. Die 9B Variante braucht rund 5,6 GB, die 35B Variante rund 21 GB. Beide bringen 256K Kontext mit, das schafft Luft für größere Codebasen.
          ollama run ornith

ollama run ornith:9b

ollama run ornith:35b
Wer lieber über eine OpenAI kompatible API arbeitet, nutzt vLLM. Damit lässt sich Ornith an bestehende Agenten anbinden, etwa an OpenCode oder eigene Tools. Empfohlene Sampling Werte laut Anbieter: temperature 0.6, top_p 0.95, top_k 20.
          vllm serve deepreinforce-ai/Ornith-1.0-9B \
  --served-model-name Ornith-1.0-9B \
  --max-model-len 262144 \
  --enable-auto-tool-choice --tool-call-parser qwen3_xml \
  --reasoning-parser qwen3 \
  --trust-remote-code
Für Teams ohne US Anbieter ist genau das der Punkt. Die Gewichte liegen offen, die Inferenz läuft auf eigener Hardware. Wer gehostete Inferenz auf Enterprise Niveau mit DSGVO Anforderungen braucht, kann sie über unseren Netzwerkpartner Conversis in Duisburg betreiben.
Ornith ist interessant für Teams, die offene Gewichte wollen und mehrstufige Aufgaben haben:
Also Arbeit, bei der ein Modell nicht nur eine Funktion schreibt, sondern über mehrere Schritte navigiert.
Weniger interessant ist es für Teams, die nur Autocomplete suchen. Dafür sind kleinere spezialisierte Modelle schneller und günstiger, etwa Qwen3.6 35B A3B oder Qwen3 Coder. Und wer bisher keine Struktur für KI-gestützte Entwicklung hat, löst sein Problem nicht mit einem neuen Modell. Da fehlt die Basis, nicht die Rechenleistung.
Unser Rat bleibt wie bei jedem Modellwechsel: erst messen, dann wechseln. Nimm zehn bis zwanzig echte Tickets aus deinem Repository, lass sie vom bisherigen Modell und von Ornith bearbeiten und vergleiche. Ohne saubere Guardrails und automatisierte Tests ist jeder Modellvergleich Bauchgefühl.
Self-Scaffolding LLMs for Agentic Coding
Die besten lokalen Coder Modelle 2026 im Vergleich, von Qwen über Devstral bis DeepSeek und Phi, mit VRAM Bedarf, Stärken und passender Hardware für Ollama
Mehr erfahrenWir nutzen bei Never Code Alone lokale Inferenz über Ollama als Standard. Qwen3 Coder und Llama laufen bei uns täglich, dazu Ollama Cloud, GLM-5 Turbo über Z.AI und MiniMax. Daher kommt unser Blick auf neue Modelle: Nicht der Benchmark entscheidet, sondern wie das Modell an echtem Code arbeitet.
Was wir immer wieder sehen: Teams wechseln zu schnell und messen zu wenig. Ein neues Modell erscheint, die Zahlen sehen gut aus, der Stack wird umgestellt. Zwei Wochen später ist unklar, ob etwas besser geworden ist. Deshalb bauen wir mit Teams erst die Messung, dann den Wechsel, zum Beispiel mit agentischen Akzeptanztests.
Wenn du Ornith oder ein anderes offenes Modell ins Team holen willst, helfen wir im Vibe Coding Consulting, beim Auswählen ohne US Anbieter und mit den Best Practices für KI-gestützte Entwicklung. Dazu kommt Testing: Ohne solide Frontend Basis und automatisierte Tests bringt kein Modell Sicherheit ins Projekt.
Roland Golla ist Entwickler aus Leidenschaft – seit über 20 Jahren. Er hat hunderte Projekte begleitet, von Legacy-Refactoring bis KI-Integration. Bei Vibe Coding verbindet er das Beste aus beiden Welten: Die Geschwindigkeit von KI-generiertem Code mit der Qualität professioneller Softwareentwicklung. Kein Bullshit, keine Agentur-Floskeln – direkte Hilfe von jemandem, der selbst täglich im Code steckt.
Die wichtigsten Fragen zu Ornith 1.0, zum gelernten Scaffold, zu den vier Modellgrößen und zum lokalen Betrieb.
Ornith 1.0 ist eine Familie offener Coding Modelle von DeepReinforce, veröffentlicht im Juni 2026. Der Name kommt vom altgriechischen Wort für Vogel. Die Modelle sind auf Gemma 4 und Qwen 3.5 nachtrainiert und stehen unter MIT Lizenz auf Hugging Face. Sie sind auf agentische Coding Aufgaben ausgelegt, also mehrstufige Arbeit mit Tools, Tests und Fehlerkorrektur.
Vier Varianten: 9B Dense für Edge und lokale Hardware, 31B Dense, 35B MoE und 397B MoE als Frontier Größe. Über Ollama sind 9B und 35B verfügbar, beide mit 256K Kontextfenster. Das 9B Modell belegt rund 5,6 GB, das 35B rund 21 GB. Damit läuft die kleine Variante auf normaler Entwicklerhardware.
Es bezieht sich auf das Training, nicht auf die Nutzung. Während des Reinforcement Learning lernt das Modell nicht nur die Lösung, sondern auch das Scaffold, das zur Lösung führt. Die fertigen Gewichte verbessern sich bei dir im Betrieb nicht weiter. Wer den Begriff anders liest, erwartet etwas, das das Modell nicht liefert.
Das lässt sich pauschal nicht sagen. Ornith ist noch jung und hat bei uns keine Production Historie. Für Evaluierung, lokale Experimente und Triage von Testfehlern ist die 9B Variante gut geeignet. Für Production gilt dasselbe wie bei jedem Modell: eigene Tests, eigene Guardrails, eigene Messung an der eigenen Codebase.
Die Gewichte sind kostenlos unter MIT Lizenz verfügbar, ohne regionale Einschränkungen. Kosten entstehen nur durch Hardware oder gehostete Inferenz. Wer lokal über Ollama arbeitet, zahlt Strom und Rechenzeit statt Token. Genau das macht kleine Modelle wie die 9B Variante für Teams mit Budgetdruck interessant.
Das Scaffold ist die Ablauflogik um das Modell herum. Es legt fest, welche Tools aufgerufen werden, wann ein Retry passiert und wie eine große Aufgabe in Teilschritte zerfällt. Bei den meisten Agenten bauen Menschen dieses Gerüst per Hand. Ornith lernt es im Training selbst und bringt diese Ablauflogik mit.
Ja. Der Befehl ollama run ornith startet die Standardvariante. Mit ornith:9b und ornith:35b lassen sich die Größen gezielt wählen. Alternativ läuft das Modell über vLLM mit OpenAI kompatibler API, FP8 und GGUF Builds sind veröffentlicht. Für Teams ohne US Anbieter ist die lokale Route der saubere Weg.
DeepReinforce nennt für die 9B Variante 43,1 auf Terminal Bench 2.1 und 69,4 auf SWE Bench Verified. Die 35B Variante kommt auf 75,6, das große 397B Modell auf 82,4 auf SWE Bench Verified und 62,2 auf SWE Bench Pro. Alle Zahlen stammen vom Anbieter. Eigene Messungen an der eigenen Codebase bleiben Pflicht.
Nur bedingt. Die Studie SWE ABS aus März 2026 fand, dass etwa jeder fünfte als gelöst markierte Patch der Top Agents semantisch falsch ist und nur wegen schwacher Tests durchläuft. Benchmarks zeigen Tendenzen, keine Wahrheit. Wer Modelle auswählt, sollte sie an echten Tickets aus dem eigenen Repository messen.
Ornith ist auf Qwen 3.5 und Gemma 4 nachtrainiert, teilt also die Basis mit verwandten Modellen. Der Unterschied liegt im Trainingsverfahren mit gelerntem Scaffold. In der Praxis heißt das: ähnliche Basisqualität, potenziell bessere Ablauflogik bei mehrstufigen Aufgaben. Ob das im Alltag trägt, zeigt nur der eigene Test.
Für die 9B Variante nicht zwingend. Quantisiert über Ollama läuft sie auf gut ausgestatteten Entwicklerrechnern, in voller Präzision passt sie auf eine einzelne starke GPU. Die großen MoE Varianten brauchen Multi GPU Setups mit Tensor Parallelism. Wer nur lokal testen will, startet mit 9B.
MIT ist eine der freizügigsten Open Source Lizenzen. Kommerzielle Nutzung, Anpassung und Weitergabe sind erlaubt, solange der Lizenztext erhalten bleibt. Für Unternehmen entfällt damit die übliche Prüfung auf Nutzungsbeschränkungen. DeepReinforce nennt zusätzlich ausdrücklich den Verzicht auf regionale Sperren.
Mit einem kurzen Evaluierungslauf an echten Aufgaben. Zehn bis zwanzig reale Tickets aus dem Repository, gleiche Prompts, gleiche Bewertung wie bei den bisherigen Modellen. Danach steht fest, ob sich der Wechsel lohnt. Wir begleiten Teams bei genau solchen Vergleichen und bauen die Messung mit auf.
Nein. Ornith ist ein Modell, kein Agent. Es braucht weiterhin eine Umgebung wie Claude Code, OpenCode oder eine eigene Anbindung über die API. Der Unterschied liegt darin, dass das Modell mehr Ablauflogik selbst mitbringt und weniger auf ein starres Gerüst angewiesen ist.
Sehr gut. Die Gewichte liegen offen, die Lizenz ist frei, der Betrieb läuft lokal oder auf eigener Infrastruktur. Es gibt keinen Zwang zu einer fremden Cloud. Für Teams, die Inferenz im eigenen Haus halten wollen, ist das eine ernsthafte Option neben Qwen3 Coder und GLM.