
Code Qualität mit KI Agenten 2026
So sichern Sie hohe Code Qualität mit KI Agenten, mit Best Practices für Konfigurationsdateien, Sub Agents und strukturierte Review Workflows
Mehr erfahren
Die Jagged Technological Frontier, kurz Jagged Frontier, beschreibt die gezackte Grenze dessen, was KI gut kann. Manche Aufgaben löst ein Sprachmodell brillant, andere, die sich ganz ähnlich anfühlen, löst es überzeugend falsch.
Den Begriff prägten 2023 Forscher von Harvard Business School, Wharton und MIT in einem Experiment mit 758 Beratern der Boston Consulting Group. Innerhalb der Grenze wurden die Berater mit KI deutlich schneller und besser. Bei einer Aufgabe knapp außerhalb lagen sie mit KI 19 Prozentpunkte seltener richtig als ohne.
Für Teams mit KI Coding Agents ist das die wichtigste Lektion: Drei starke Antworten sagen nichts über die vierte. Deshalb braucht es Prüfungen, die nicht vom Gefühl abhängen.
Ein Tag inhouse mit Benjamin Klein für Developer, Tester und Admins. Context Engineering, Harness, ADRs und zwei Hands on Blöcke mit KI Agenten in eurem Setup.

Wir arbeiten jeden Tag mit KI Coding Agents und kennen beide Seiten der Grenze. OpenCode mit Open Weight Modellen schreibt bei uns große Teile des Codes. Geprüft wird alles durch PHPStan, Psalm, Rector, PHPUnit und Cypress in GitHub Actions und GitLab CI. Roland Golla ist Cypress Ambassador und beschäftigt sich seit über 20 Jahren mit Softwarequalität.
Im Vibe Coding Consulting richten wir mit Teams Regeln und Quality Gates für Agents ein. Das CI/CD Pipeline Setup sorgt dafür, dass nur geprüfter Code live geht. Mit dem NCA Cypress E2E Testing Setup sichern wir die wichtigsten Nutzerwege ab. Wie Regeln für Agents konkret aussehen, zeigen die NCA PHP AI Coding Guidelines. Developer lernen das hands on im NCA KI Workshop für Developer.
Fabrizio Dell'Acqua, Ethan Mollick, Karim Lakhani und weitere Forscher haben das Experiment 2023 gemeinsam mit der Boston Consulting Group durchgeführt. Es war vorregistriert, also vorab mit Hypothesen und Methode festgelegt. 758 Berater nahmen teil, rund sieben Prozent der BCG Berater auf dieser Ebene. Die Hälfte arbeitete mit GPT-4, ein Teil davon zusätzlich mit einer kurzen Einführung ins Prompting.
Die Forscher teilten die Aufgaben bewusst in zwei Gruppen:
Die vollständige Studie ist als Working Paper der Harvard Business School frei verfügbar.
Gezackt heißt: Die Grenze verläuft nicht entlang von leicht und schwer. Eine Aufgabe, die für Menschen kompliziert wirkt, schafft die KI oft mühelos. Eine scheinbar einfache Aufgabe direkt daneben geht schief. Von außen sieht man das nicht.
Dazu kommt: Die KI klingt in beiden Fällen gleich sicher. Es gibt kein Warnsignal im Ton, keine Lücke im Stil. Wer nach mehreren guten Ergebnissen Vertrauen aufbaut, prüft beim nächsten Mal weniger genau. Genau dort passiert der Fehler.
Neue Modelle verschieben die Grenze. Viele Aufgaben, die 2023 außerhalb lagen, liegen heute innerhalb. Unsichtbar bleibt die Grenze trotzdem. Deshalb hilft es wenig, auf das nächste Modell zu warten.
Eine zweite Studie zeigt, warum wir die Grenze so schlecht erkennen. Mark Steyvers und Kollegen von der UC Irvine haben 2025 in Nature Machine Intelligence untersucht, wie Menschen die Antworten von Sprachmodellen einschätzen.
Das Ergebnis:
Für den Dev Alltag heißt das: Eine lange, saubere Architekturbegründung im Chat fühlt sich nach Beweis an. Sie ist keiner. Ein grüner Test ist einer.
Die Forscher haben auch beobachtet, wie erfolgreiche Berater mit der KI gearbeitet haben. Dabei zeigten sich zwei Muster:
Beide Muster haben eines gemeinsam: Der Mensch bleibt aktiv im Prozess. Wer die KI einfach machen lässt und das Ergebnis übernimmt, fällt an der gezackten Grenze am härtesten.
Beim Coding ist die gezackte Grenze besonders gut zu sehen. Ein Agent baut in Minuten ein komplettes Formular mit Validierung. Im nächsten Schritt erfindet er eine Methode, die es in der Bibliothek nicht gibt. Oder er löst das technische Problem sauber und geht am fachlichen Problem vorbei.
Mit AI Agents wird das kritischer. Ein Chatbot antwortet nur, ein Mensch liest mit. Ein Agent handelt: Er schreibt Dateien, führt Befehle aus, öffnet Merge Requests. Ein Fehler außerhalb der Grenze bleibt dann nicht im Chatfenster. Er landet im Repository.
Wenn KI den Code schreibt, die Tests schreibt und eine andere KI das Review macht, kann alles grün sein und trotzdem das Falsche gebaut werden. Welche Tests mit Agents wichtiger werden, beschreibt unser Beitrag zur Testpyramide für KI Agents. Typische Fallen sammelt die Seite zu Vibe Coding Risiken.
Die Tabelle folgt einer einfachen Regel: Die KI darf alles, was ein automatisches Gate prüft und was sich zurückdrehen lässt. Code ohne Merge lässt sich verwerfen. Ein Merge ohne Mensch oder ein Eingriff ins Produktivsystem lässt sich nicht so leicht zurückholen.
Gegen eine unsichtbare Grenze hilft eine feste Kette von Prüfungen, die jeden Agent Commit gleich behandelt:
Wie diese Regeln für Agents aufgebaut werden, zeigt die Seite Code Qualität mit KI Agenten. Sicherheitsthemen behandelt Vibe Coding Security.
There's a disconnect between what LLMs know and what people think they know.
Steyvers beschreibt eine Lücke zwischen zwei Dingen: wie sicher sich ein Sprachmodell intern ist und wie sicher Menschen das Modell wahrnehmen. Die Modelle haben oft ein brauchbares Gefühl für ihre eigene Unsicherheit. In der Antwort kommt das aber selten an.
Zusammen mit der BCG Studie ergibt das ein klares Bild. Die Grenze der KI ist gezackt, und unser Gespür dafür ist schlecht. Längere und sauber formulierte Antworten machen es noch schlechter.
Die Konsequenz für Teams: Vertrauen gehört nicht in den Prozess. Prüfungen gehören hinein. Ein Test fragt nicht, wie überzeugend der Code klingt.
So sichern Sie hohe Code Qualität mit KI Agenten, mit Best Practices für Konfigurationsdateien, Sub Agents und strukturierte Review Workflows
Mehr erfahrenBei NCA schreibt die KI jeden Tag Code. OpenCode mit Open Weight Modellen ist unser Coding Agent, kleine Modelle laufen lokal über Ollama. Weil wir die gezackte Grenze kennen, laufen bei uns alle Agent Commits durch dieselben Gates wie menschlicher Code. Wie die Strecke vom Commit bis live aussieht, zeigt unser Beitrag zur CI CD Pipeline mit Docker und Staging.
Teams helfen wir in mehreren Schritten. Im Vibe Coding Consulting setzen wir Regeln und Rechte für Agents auf. Mit dem CI/CD Pipeline Setup und dem NCA Cypress E2E Testing Setup entstehen die Gates. Für bestehende Projekte bringt die NCA Soforthilfe für Webprojekte schnelle Unterstützung.
Wer tiefer einsteigen will: Die Vibe Coding Prompting Seite zeigt, wie klare Aufträge Fehler früh verhindern. Die Seite zu Skalierbarkeit und Wartbarkeit erklärt, wann Vibe Coding an seine Grenzen kommt. Einen Überblick über Tools gibt Top 10 Vibe Coding Tools, zum Beispiel mit GitHub Copilot.
Für Developer gibt es den NCA KI Workshop für Developer, für ganze Belegschaften den NCA KI Workshop für alle Abteilungen. Welche Entscheidungen bei uns immer beim Menschen bleiben, beschreibt unser Blog Beitrag zur roten Linie für KI im Coding.
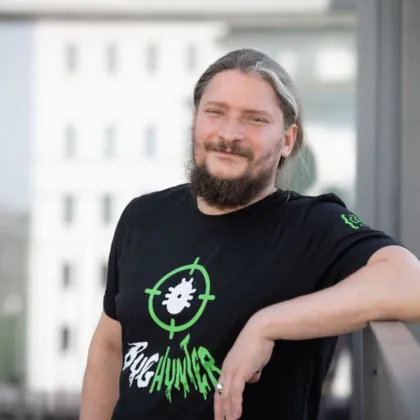
Roland Golla ist Entwickler aus Leidenschaft – seit über 20 Jahren. Er hat hunderte Projekte begleitet, von Legacy-Refactoring bis KI-Integration. Bei Vibe Coding verbindet er das Beste aus beiden Welten: Die Geschwindigkeit von KI-generiertem Code mit der Qualität professioneller Softwareentwicklung. Kein Bullshit, keine Agentur-Floskeln – direkte Hilfe von jemandem, der selbst täglich im Code steckt.
Die wichtigsten Antworten zur gezackten Grenze der KI, zur BCG Studie und zum sicheren Arbeiten mit KI Coding Agents.
Jagged Frontier steht für die gezackte Grenze dessen, was KI gut kann. Manche Aufgaben löst ein Sprachmodell brillant, ähnlich wirkende Aufgaben löst es überzeugend falsch. Der Begriff stammt aus einer Studie mit 758 BCG Beratern von 2023 und ist 2026 aktueller denn je, weil KI Agents immer mehr Arbeit selbst ausführen.
Ja. Neue Modelle verschieben die Grenze, viele Aufgaben von damals liegen heute innerhalb. Gezackt und unsichtbar bleibt die Grenze aber. Auch aktuelle Modelle liefern bei einzelnen Aufgaben plausible, falsche Ergebnisse mit derselben Sicherheit wie richtige. Deshalb ersetzt kein neues Modell automatische Prüfungen im Entwicklungsprozess.
Innerhalb der Grenze erledigten Berater mit GPT-4 12,2 Prozent mehr Aufgaben, waren 25,1 Prozent schneller und lieferten über 40 Prozent höhere Qualität. Bei einer Aufgabe außerhalb der Grenze lagen sie mit KI 19 Prozentpunkte seltener richtig als ohne KI. Gleiches Werkzeug, komplett anderes Ergebnis.
Ein Agent kann ein Feature in Minuten sauber bauen und beim nächsten Schritt eine Methode erfinden, die es nicht gibt. Weil Agents Dateien schreiben und Befehle ausführen, landen solche Fehler direkt im Repository. Statische Analyse, Tests und eine Pipeline mit menschlicher Freigabe fangen sie ab, bevor sie live gehen.
Bei NCA bleiben Merge, Architekturentscheidungen, die Live Freigabe und jeder Zugriff aufs Produktivsystem beim Menschen. Die KI darf Code schreiben, Reviews vorbereiten und Varianten vorschlagen. Die Faustregel: Alles, was ein automatisches Gate prüft und sich zurückdrehen lässt, darf die KI machen. Der Rest braucht eine menschliche Entscheidung.
Der Begriff stammt aus dem Working Paper von Fabrizio Dell'Acqua, Edward McFowland III, Ethan Mollick, Hila Lifshitz-Assaf, Katherine Kellogg und weiteren Forschern von Harvard Business School, Wharton und MIT. Sie haben das Experiment 2023 gemeinsam mit der Boston Consulting Group durchgeführt und vorab registriert.
Eine Studie von Mark Steyvers und Kollegen in Nature Machine Intelligence zeigt: Längere Erklärungen eines Sprachmodells erhöhen das Vertrauen der Leser. Sie helfen aber nicht dabei, richtige von falschen Antworten zu unterscheiden. Die Länge wirkt wie ein Qualitätssignal, obwohl sie keines ist. Für Teams heißt das: Tests statt Bauchgefühl.
So nennen die Forscher zwei erfolgreiche Arten, mit KI zu arbeiten. Centaurs teilen die Arbeit klar auf, manche Schritte macht der Mensch, manche die KI. Cyborgs verweben ihre Arbeit eng mit der KI und prüfen laufend nach. In beiden Fällen bleibt der Mensch aktiv beteiligt und übernimmt Ergebnisse nicht blind.
Meist gar nicht am Ergebnis selbst. Die KI klingt außerhalb der Grenze genauso sicher wie innerhalb. Hinweise sind Aufgaben, die mehrere Quellen verbinden, fachliches Wissen über euer Projekt brauchen oder neue Bibliotheken betreffen. Verlässlich erkennt ihr Fehler nur über Prüfungen wie Tests, statische Analyse und fachliches Review.
Ein Review Agent ist eine gute Ergänzung und findet viele Fehler. Er liegt aber selbst irgendwo auf der gezackten Grenze. Wenn Code, Tests und Review von KI stammen, kann alles grün sein und das Falsche gebaut werden. Deshalb kombinieren wir KI Review mit statischer Analyse, Cypress Tests und einer menschlichen Freigabe.
Bewährt hat sich eine feste Kette: statische Analyse mit PHPStan, Psalm oder Ruff, Unit Tests, Cypress E2E Tests für die wichtigsten Nutzerwege und eine Pipeline in GitHub Actions oder GitLab CI. Dazu kommen Regeldateien für den Agent und geschützte Branches. Live geht nur, was alle Prüfungen bestanden hat.
NCA richtet mit Teams Regeln für Coding Agents, Quality Gates und Pipelines ein, hands on im eigenen Projekt. Developer lernen den Umgang im NCA KI Workshop für Developer. Im kostenlosen Kennenlernen schätzen wir den Aufwand, abgerechnet wird transparent auf die Minute, ohne Pakete oder Festpreise.